文章归档

学习笔记

Go-Server/Client以及PHP-Client之间的GRPC初次尝试

写这篇笔记的目的

为了应对后续开发生涯中可能遇到的种种情况以及分布式计算的趋势(讲白了就是后续对工作会很有帮助)。如若总是依赖http-api/restful编写并提供外部调用接口,当接口数量不断上升,文档内容不断增加,这给设计者和使用者都带来非常不好的体验,而RPC在这体就现出了非常大的优势。我将自己的理解和体会以及学习的过程记录在这里,以便今后遇到问题能够从这儿获得些许的线索以及提供一个参考给同道中人。

前提

不妨思考这样一个情形:作为接口设计者,我早已经定义好的接口的请求方式(RESTFul)和返回结构(json),但是每个接口我还需要另外维护一个文档来说明各个接口的用法(请求参数)和解释返回的结果(字段描述)。而对于接口的调用者而言,不但要去文档中查找自己需要的接口并阅读说明,在实际调用中,还要以防接口提供者返回非既定结构的结果而导致的报错。

介绍

Remote Procedure Call(远程过程调用),简称RPC。它可以使得调用远程服务接口如同调用本地方法一样简单。虽然实质还是通过网络通信,但是相比http请求api的网络开销还是极小的,其原因简单来说,HTTP协议每次请求都需要建立TCP连接,就会涉及3次握手的网络开销问题以及冗余报文,而rpc直接使用TCP多路复用(gRPC基于HTTP/2)无需重复建立连接。就文档方面而言,编写一份开发文档足矣,因为接口的定义由接口定义语言(IDL)来完成,而阅读IDL便可理解所有接口,并且通过编译器可以将IDL编译成不同的语言实现源码(gRPC通过protoc编译器将protobuf编译)。其他优点例如:注册、监控、发布等的这里不做论述。

Go-Server

GRPC的官方资源:go get google.golang.org/grpc

GRPC的镜像资源:https://github.com/grpc/grpc

官方的相关示列可以在grpc/examples/中找到。

定义服务

使用protocol buffers去定义gRPC service和方法 request以及 response 的类型。

新增并编辑文件:something.proto

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
syntax = "proto3";

// 声明包/作用域
package something;

// 定义一个服务,名为Wiwider
service Wiwider {
rpc FindUser (UserRequest) returns (UserReply) {} // 声明一个方法
rpc FindUsers (UserRequest) returns (UsersReply) {}
}

// 定义一个请求消息
message UserRequest {
string name = 1;
}

// 定义一个响应消息
message UserReply {
int64 id = 1;
string name = 2;
int32 age = 3;
sexes sex = 4;

enum sexes {
Male = 0;
Female = 1;
}
}

// 定义一个包含消息的消息
message UsersReply {
repeated UserReply users = 1;
}

生成代码

Go-代码

1
protoc --go_out=plugins=grpc:. something.proto

运行这个命令后,会在当前目录生成一个something.pb.go文件,内容包含:

  • 所有用于填充,序列化和获取我们请求和响应消息类型的 protocol buffer 代码
  • 一个为客户端调用定义在Wiwider服务的方法的接口类型(或者 存根 )
  • 一个为服务器使用定义在Wiwider服务的方法去实现的接口类型(或者 存根 )

PHP-代码

1
protoc --proto_path=./ --php_out=./ --grpc_out=./ --plugin=protoc-gen-grpc=/Users/anthony/git/grpc/bins/opt/grpc_php_plugin ./something.proto

其中/Users/anthony/git/grpc/bins/opt/grpc_php_plugin对应从git中获取的<grpc-git-path>/bins/opt/grpc_php_plugin

运行这个命令后,会在当前目录生成如下:

  • GPBMetadata/something.php
  • Something/UserReply/sexes.php
  • Something/UserReply.php
  • Something/UserReply_sexes.php
  • Something/UserRequest.php
  • Something/UsersReply.php
  • Something/WiwiderClient.php

创建服务器

首先我们需要实现服务定义的服务接口:

something/something.go

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
package something

import (
"Wiwide/cmi"
"context"
)
type UserServer struct {

}

func (s *UserServer) FindUser(ctx context.Context, in *UserRequest) (*UserReply, error) {
name := in.GetName()
rs, err := cmi.Db("local").Table("users").Where("name", name).First() // 从数据库查询
if err != nil || len(rs) == 0 {
return &UserReply{},err
}
rId := rs["id"].(int64)
rName := rs["name"].(string)
rAge := int32(rs["age"].(int64))
rSex := UserReplySexes(rs["sex"].(int64))
rep := &UserReply{Id:rId,Name:rName,Age:rAge,Sex:rSex}
return rep, nil
}

func (s *UserServer) FindUsers(ctx context.Context, in *UserRequest) (*UsersReply, error) {
name := in.GetName()
rs, err := cmi.Db("local").Table("users").Where("name","like","%"+name+"%").Get() // 从数据库查询
if err != nil {
return &UsersReply{}, err
}
list := make([]*UserReply, 0)
for _, v := range rs {
rId := v["id"].(int64)
rName := v["name"].(string)
rAge := int32(v["age"].(int64))
rSex := UserReplySexes(v["sex"].(int64))
list = append(list, &UserReply{Id:rId,Name:rName,Age:rAge,Sex:rSex})
}
rep := &UsersReply{Users: list}
return rep, nil
}

然后运行一个gRPC服务器,注册我们的服务并监听来自客户端的请求:

server.go

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
package main

import (
"Wiwide/rpc/something"
"context"
"google.golang.org/grpc"
"google.golang.org/grpc/reflection"
"log"
"net"
)

var (
port = ":50051"
)
func main() {
lis, err := net.Listen("tcp", port)
if err != nil {
log.Fatalf("failed to listen: %v", err)
}
s := grpc.NewServer()
something.RegisterWiwiderServer(s, &something.UserServer{})
reflection.Register(s)
if err := s.Serve(lis); err != nil {
log.Fatalf("failed to serve: %v", err)
}
}

运行服务器

简单执行命令:go run server.go,然后等待客户端请求。

创建客户端

Go-Client

创建文件client.go

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
package main

import (
"Wiwide/rpc/something"
"context"
"google.golang.org/grpc"
"log"
"os"
"time"
)

const(
address = "localhost:50051"
defaultName = "World"
)

func main(){
conn, err := grpc.Dial(address, grpc.WithInsecure())
if err != nil {
log.Fatalf("did not connect: %v", err)
}
defer conn.Close()

name := defaultName
if len(os.Args) > 1 {
name = os.Args[1]
}
ctx, cancel := context.WithTimeout(context.Background(), time.Second)
defer cancel()
s := something.NewWiwiderClient(conn)
u, err := s.FindUser(ctx, &something.UserRequest{Name:name})
if err != nil {
log.Fatalf("could not Find: %v", err)
}
us, err := s.FindUsers(ctx, &something.UserRequest{Name:name})
if err != nil {
log.Fatalf("could not Find users: %v", err)
}
log.Printf("Find user: %v", u)
log.Printf("Find users: %v", us)
}

PHP-Client

PHP首先要安装grpc的php扩展,下载地址:http://pecl.php.net/package/gRPC

直接使用phpize安装:

1
2
3
4
5
6
7
8
tar -zxf grpc-1.17.0.tgz
cd grpc-1.17.0
phpize
./configure --with-php-config=/usr/local/php/bin/php-config
make
make install
# 在php.ini中增加
extension = grpc.so

执行php -m | grep grpc 应该会输出”grpc”,就代表成功了。

创建客户端文件,这里需要用到composer获取两个包,其中composer.json内容为:

1
2
3
4
5
6
7
8
{
"name": "grpc/grpc-demo",
"description": "gRPC example for PHP",
"require": {
"grpc/grpc": "^v1.3.0",
"google/protobuf": "^v3.3.0"
}
}

something.php

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
<?php
require dirname(__FILE__).'/vendor/autoload.php';

include_once dirname(__FILE__).'/Something/UserReply.php';
include_once dirname(__FILE__).'/Something/UsersReply.php';
include_once dirname(__FILE__).'/Something/UserRequest.php';
include_once dirname(__FILE__).'/Something/WiwiderClient.php';
include_once dirname(__FILE__).'/GPBMetadata/Something.php';

$client = new Something\WiwiderClient('127.0.0.1:50051', ['credentials' => Grpc\ChannelCredentials::createInsecure()]);
$req = new Something\UserRequest();
$name = !empty($argv[1]) ? $argv[1] : 'world';
$req->setName($name);
list($reply, $status) = $client->FindUser($req)->wait();
var_dump($reply->getId(), $reply->getName(), $reply->getAge(), $reply->getSex(), $status);

list($reply, $status) = $client->FindUsers($req)->wait();
$uers = $reply->getUsers();
$users = array();
foreach ($uers as $key => $value) {
array_push($users, array('id'=>$value->getId(),'name'=>$value->getName(),'age'=>$value->getAge(),'sex'=>$value->getSex()));
}
var_dump($users);

运行客户端

Go-Client

我们先编译一下:go build client.go,输出可执行文件client,然后直接运行:

  • ./client Anthony
  • ./client ny

分别输出如下:

1
2
2018/12/02 13:40:15 Find user: id:1 name:"Anthony" age:24 sex:Female 
2018/12/02 13:40:15 Find users: users:<id:1 name:"Anthony" age:24 sex:Female >
1
2
2018/12/02 13:40:25 Find user: 
2018/12/02 13:40:25 Find users: users:<id:1 name:"Anthony" age:24 sex:Female > users:<id:4 name:"funny" age:15 sex:2 >

PHP-Client

直接执行PHP文件:php something.php Anthonyphp something.php ny,结果如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
int(1)
string(7) "Anthony"
int(24)
int(1)
object(stdClass)#8 (3) {
["metadata"]=>
array(0) {
}
["code"]=>
int(0)
["details"]=>
string(0) ""
}
array(1) {
[0]=>
array(4) {
["id"]=>
int(1)
["name"]=>
string(7) "Anthony"
["age"]=>
int(24)
["sex"]=>
int(1)
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
int(0)
string(0) ""
int(0)
int(0)
object(stdClass)#8 (3) {
["metadata"]=>
array(0) {
}
["code"]=>
int(0)
["details"]=>
string(0) ""
}
array(2) {
[0]=>
array(4) {
["id"]=>
int(1)
["name"]=>
string(7) "Anthony"
["age"]=>
int(24)
["sex"]=>
int(1)
}
[1]=>
array(4) {
["id"]=>
int(4)
["name"]=>
string(5) "funny"
["age"]=>
int(15)
["sex"]=>
int(2)
}
}

结束

本次笔记接近结尾了,内容很简单,主要记录使用grpc的大体流程。为后续的测试做一点点的准备。

参考资料

阅读剩下更多

默认配图
编程语言

Go语言包-path/filepath

一天一个Golang包,慢慢学习之“path/filepath”

上一篇学习了path包,了解了几个对路径处理的方法。今天继续完成它的子包“filepath”,包中的函数会根据不同平台做不同的处理,如路径分隔符、卷名等。

阅读文档:

官方pkg地址:https://golang.org/pkg/path/filepath

包方法

func Base(path string) string
func Clean(path string) string
func Dir(path string) string
func Ext(path string) string
func IsAbs(path string) bool
func Join(elem ...string) string
func Match(pattern, name string) (matched bool, err error)
func Split(path string) (dir, file string)
// 以上8种方法跟path包同名方法功能类似


func Abs(path string) (string, error)
// 返回相对当前路径的path的绝对路径

1
2
3
4
5
6
7
8
9
10
11
12
fmt.Println(filepath.Abs(""))
fmt.Println(filepath.Abs("name.txt"))
fmt.Println(filepath.Abs("/name.txt"))
fmt.Println(filepath.Abs("../name.txt"))
fmt.Println(filepath.Abs("~/../name.txt"))
/*
/Users/anthony/Workspaces/GoLand/src/application/learn/path/filepath <nil>
/Users/anthony/Workspaces/GoLand/src/application/learn/path/filepath/name.txt <nil>
/name.txt <nil>
/Users/anthony/Workspaces/GoLand/src/application/learn/path/name.txt <nil>
/Users/anthony/Workspaces/GoLand/src/application/learn/path/filepath/name.txt <nil>
*/

func EvalSymlinks(path string) (string, error)
// 返回Path的实际路径(如果path是个软链接的话)

1
2
fmt.Println(filepath.EvalSymlinks("/etc"))		// /private/etc <nil>
fmt.Println(filepath.EvalSymlinks("/usr/local"))// /usr/local <nil>

func ToSlash(path string) string
func FromSlash(path string) string
// 以上两种方法作主要用于Windows平台。
// 将path中的平台相关的路径分隔符(或’/‘)转换为’/‘(或平台相关的路径分隔符)


func Glob(pattern string) (matches []string, err error)
// 列出与指定模式pattern完全匹配的文件或目录,匹配原则同Match一样。

1
2
fmt.Println(filepath.Glob("/usr/*"))
// [/usr/bin /usr/include /usr/lib /usr/libexec /usr/local /usr/sbin /usr/share /usr/standalone] <nil>

func HasPrefix(p, prefix string) bool
// 该方法已弃用,不再被建议使用。


func Rel(basepath, targpath string) (string, error)
// 返回targpath相对于basepath的路径。
// 要求二者必须同为“相对路径”或“绝对路径”

1
2
3
4
fmt.Println(filepath.Rel("/usr/local","/usr/local/bin/go"))			// bin/go <nil>
fmt.Println(filepath.Rel("/usr/local","/usr/local/../local/bin/go"))// bin/go <nil>
fmt.Println(filepath.Rel("/usr/local","/usr/bin/go")) // ../bin/go <nil>
fmt.Println(filepath.Rel("/usr/local","/")) // ../.. <nil>

func SplitList(path string) []string
// 将路径序列path分割为多条独立路径。
// path类似Unix/Linux下的环境变量PATH。

1
2
fmt.Printf("%q\n", filepath.SplitList("/bin:/sbin:/usr/bin:/usr/sbin  : /usr/local/bin"))
// ["/bin" "/sbin" "/usr/bin" "/usr/sbin " " /usr/local/bin"]

func VolumeName(path string) string
// 返回路径字符中的卷名
// Windows 中的 C:\Windows 会返回”C:”
// Linux 中的 //dev/host/dir 会返回 //dev/host


func Walk(root string, walkFn WalkFunc) error
// 遍历指定目录root(包括子目录),对遍历到的项目用walkFn函数进行处理。
// walkFn返回nil,则walkFn继续遍历,如果返回SkipDir,则Walk函数跳过当前目录,继续遍历下一目录。
// 如果返回其他错误,则Walk函数终止。
// 在Walk遍历过程中,如遇到错误,则会将错误通过err传递给walkFn,同时跳过出错的项目,继续处理后续项目。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
// 打印目录及目录下所有文件及大小
fn := func(path string, info os.FileInfo, err error) error {
if err != nil {
return err
}
fmt.Printf("%q, %q, %d\n", path, info.Name(), info.Size())
return nil
}

filepath.Walk("/Users/anthony/Downloads/conf", fn)
/*
"/Users/anthony/Downloads/conf", "conf", 224
"/Users/anthony/Downloads/conf/0x4f5da2.cn.key", "0x4f5da2.cn.key", 1700
"/Users/anthony/Downloads/conf/0x4f5da2.cn_bundle.crt", "0x4f5da2.cn_bundle.crt", 3323
"/Users/anthony/Downloads/conf/world.cert.key.pem", "world.cert.key.pem", 1675
"/Users/anthony/Downloads/conf/world.dev.bundle.crt", "world.dev.bundle.crt", 2802
"/Users/anthony/Downloads/conf/world.local.bundle.crt", "world.local.bundle.crt", 2863
*/

// WalkFunc 函数:
// 列出含有 *.txt 文件的目录(不是全部,因为会跳过一些子目录)
findTxtDir := func(path string, info os.FileInfo, err error) error {
ok, err := filepath.Match(`*.txt`, info.Name())
if ok {
fmt.Println(filepath.Dir(path), info.Name())
// 遇到 txt 文件则继续处理所在目录的下一个目录
// 注意会跳过子目录
return filepath.SkipDir
}
return err
}
// 列出含有 *.txt 文件的目录(不是全部,因为会跳过一些子目录)
err := filepath.Walk(`/usr`, findTxtDir)
fmt.Println(err)
/*
/usr/local/Cellar/chromaprint/1.4.3 NEWS.txt
/usr/local/Cellar/fontconfig/2.13.1/share/doc/fontconfig fontconfig-devel.txt
/usr/local/Cellar/frei0r/1.6.1 AUTHORS.txt
/usr/local/Cellar/game-music-emu/0.6.2 changes.txt
...
<nil>
*/

// WalkFunc 函数:
// 列出所有以 ab 开头的目录(全部,因为没有跳过任何项目)
findabDir := func(path string, info os.FileInfo, err error) error {
if info.IsDir() {
ok, err := filepath.Match(`[aA][bB]*`, info.Name())
if err != nil {
return err
}
if ok {
fmt.Println(path)
}
}
return nil
}
// 列出所有以 ab 开头的目录(全部,因为没有跳过任何项目)
err = filepath.Walk(`/usr`, findabDir)
fmt.Println(err)
/*
/usr/local/Cellar/node/11.0.0/libexec/lib/node_modules/npm/node_modules/abbrev
/usr/local/Homebrew/Library/Taps/homebrew/homebrew-services/.git/objects/ab
/usr/local/lib/node_modules/gulp/node_modules/resolve/test/dotdot/abc
/usr/local/lib/node_modules/hexo-cli/node_modules/abbrev
...
<nil>
*/


阅读剩下更多

默认配图
编程语言

Go语言包-path

一天一个Golang包,慢慢学习之“path”

上一篇学习了bytes包,内容还是有点多,花的时间也多了一点。所以今天补充点小内容-path包。当然,path还有子包:filepath,这个下次再继续。

阅读文档:

官方pkg地址:https://golang.org/pkg/path/

包方法

func Base(path string) string
// 返回最后一个元素(目录或文件)的路径

1
2
3
4
5
6
7
8
fmt.Println(path.Base("/a/b/"))	// b
fmt.Println(path.Base("/a/b")) // b
fmt.Println(path.Base("./a/b")) // b
fmt.Println(path.Base("../a/b")) // b
fmt.Println(path.Base("/")) // /
fmt.Println(path.Base("./")) // .
fmt.Println(path.Base(".")) // .
fmt.Println(path.Base("")) // .

func Clean(path string) string
// 返回最洁净的路径,在path比较复杂的情况下使用,可以简化path。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
paths := []string{
"a/c",
"a//c",
"a/c/.",
"a/c/b/..",
"/../a/c",
"/../a/b/../././/c",
"",
}
for _, p := range paths {
fmt.Printf("Clean(%q) = %q\n", p, path.Clean(p))
}
// Clean("a/c") = "a/c"
// Clean("a//c") = "a/c"
// Clean("a/c/.") = "a/c"
// Clean("a/c/b/..") = "a/c"
// Clean("/../a/c") = "/a/c"
// Clean("/../a/b/../././/c") = "/a/c"
// Clean("") = "."

func Dir(path string) string
// 返回元素(目录或文件)的目录路径

1
2
3
4
5
6
fmt.Println(path.Dir("/a/b/c"))	// /a/b
fmt.Println(path.Dir("a/b/c")) // a/b
fmt.Println(path.Dir("/a/")) // /a
fmt.Println(path.Dir("a/")) // a
fmt.Println(path.Dir("/")) // /
fmt.Println(path.Dir("")) // .

func Ext(path string) string
// 返回path下文件名的后缀

1
2
3
4
fmt.Println(path.Ext("/a/b/c/bar.css"))	// .css
fmt.Println(path.Ext("/a/b/c/bar.tar.gz")) // .gz
fmt.Println(path.Ext("/")) //
fmt.Println(path.Ext("")) //

func IsAbs(path string) bool
// 判断path是否是绝对路径

1
2
3
fmt.Println(path.IsAbs("/dev/null"))	// true
fmt.Println(path.IsAbs("dev/null")) // false
fmt.Println(path.IsAbs("./dev/null")) // false

func Join(elem ...string) string
// 将多个路径元素连接成一个,空元素会被忽略。

1
2
3
4
5
6
fmt.Println(path.Join("a", "b", "c"))	// a/b/c
fmt.Println(path.Join("a", "b/c")) // a/b/c
fmt.Println(path.Join("a/b", "c")) // a/b/c
fmt.Println(path.Join("", "")) //
fmt.Println(path.Join("a", "")) // a
fmt.Println(path.Join("", "a")) // a

func Match(pattern, name string) (matched bool, err error)
// 判断name是否符合pattern规则,并返回err

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
// pattern:
// { term }
// term:
// '*' matches any sequence of non-/ characters
// '?' matches any single non-/ character
// '[' [ '^' ] { character-range } ']'
// character class (must be non-empty)
// c matches character c (c != '*', '?', '\\', '[')
// '\\' c matches character c

// character-range:
// c matches character c (c != '\\', '-', ']')
// '\\' c matches character c
// lo '-' hi matches character c for lo <= c <= hi

fmt.Println(path.Match("abc", "abc")) // true <nil>
fmt.Println(path.Match("a*", "abc")) // true <nil>
fmt.Println(path.Match("a*d", "abcd")) // true <nil>
fmt.Println(path.Match("a*/b", "a/c/b")) // false <nil>
fmt.Println(path.Match("a/[a-f]/b", "a/c/b")) // true <nil>

func Split(path string) (dir, file string)
// 返回path的目录和文件名

1
2
3
fmt.Println(path.Split("static/myfile.css"))	// static/ myfile.css
fmt.Println(path.Split("myfile.css")) // myfile.css
fmt.Println(path.Split("")) //

子包:filepath

下一篇来学习:path/filepath

阅读剩下更多

默认配图
编程语言

Go语言包-bytes

一天一个Golang包,慢慢学习之“bytes”

今天学习bytes包,其实之前就已经使用了bytes包的很多方法了,这次主要就是再次熟悉和认识这个包里面的方法。

阅读文档:

官方pkg地址:https://golang.org/pkg/bytes/

包方法

func Compare(a, b []byte) int
// 比较a和b两个字节数组。
// if a==b return 0;
// if a < b return -1;
// if a > b return 1;

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
var a, b []byte
a = []byte{65,66,67}
b = []byte{65,66,67}
fmt.Printf("%s, %s, %d\n", a, b, bytes.Compare(a, b))

a = []byte{65,66,67}
b = []byte{65,66,68}
fmt.Printf("%s, %s, %d\n", a, b, bytes.Compare(a, b))

a = []byte{65,66,67}
b = []byte{65,66,66}
fmt.Printf("%s, %s, %d\n", a, b, bytes.Compare(a, b))

a = []byte{65,66,67}
b = []byte{65,66,67,68}
fmt.Printf("%s, %s, %d\n", a, b, bytes.Compare(a, b))

a = []byte{65,66,67,68}
b = []byte{65,66,67}
fmt.Printf("%s, %s, %d\n", a, b, bytes.Compare(a, b))
// ABC, ABC, 0
// ABC, ABD, -1
// ABC, ABB, 1
// ABC, ABCD, -1
// ABCD, ABC, 1

func Contains(b, subslice []byte) bool
// 检查subslice是不是包含在b中

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
a := []byte{65, 66, 67, 68, 69, 70}
b := []byte{65, 66, 67, 68, 69, 70}
fmt.Printf("%s, %s, %v\n", a, b, bytes.Contains(a, b))

b = []byte{65, 66, 67, 68, 69}
fmt.Printf("%s, %s, %v\n", a, b, bytes.Contains(a, b))

b = []byte{65, 66, 67, 68, 69, 70, 71}
fmt.Printf("%s, %s, %v\n", a, b, bytes.Contains(a, b))

b = []byte{66, 67, 68, 69, 70, 71}
fmt.Printf("%s, %s, %v\n", a, b, bytes.Contains(a, b))
// ABCDEF, ABCDEF, true
// ABCDEF, ABCDE, true
// ABCDEF, ABCDEFG, false
// ABCDEF, BCDEFG, false

func ContainsAny(b []byte, chars string) bool
// 检查b中是否包含chars中的任意字符

1
2
3
4
5
6
a := []byte{65, 66, 67, 68}
fmt.Printf("%v\n", bytes.ContainsAny(a, "abcd") // false
fmt.Printf("%v\n", bytes.ContainsAny(a, "a")) // false
fmt.Printf("%v\n", bytes.ContainsAny(a, "aB")) // true
fmt.Printf("%v\n", bytes.ContainsAny(a, "aBcd")) // true
fmt.Printf("%v\n", bytes.ContainsAny(a, "abcd ABC")) // true

func ContainsRune(b []byte, r rune) bool
// 判断b中是否包含r字符

1
2
3
a := []byte{65, 66, 67 ,68}
fmt.Printf("%v\n", bytes.ContainsRune(a, 'b')) // false
fmt.Printf("%v\n", bytes.ContainsRune(a, 'B')) //true

func Count(s, sep []byte) int
// sep在s中的重复次数(sep不重叠),即s=ababab,sep=abab则返回1

1
2
3
4
5
a := []byte("ababab")
sep := []byte("ab")
fmt.Printf("%d\n", bytes.Count(a, sep)) // 3
sep = []byte("abab")
fmt.Printf("%d\n", bytes.Count(a, sep)) // 1

func Equal(a, b []byte) bool
// 判断a和b是否相等,nil等同于[]byte()

1
2
3
4
5
a := []byte("ABC")
b := []byte{65, 66, 67}
fmt.Printf("%s, %s, %v\n", a, b, bytes.Equal(a, b)) // ABC, ABC, true
b = []byte{65 ,66}
fmt.Printf("%s, %s, %v\n", a, b, bytes.Equal(a, b)) // ABC, AB, false

func EqualFold(s, t []byte) bool
// 判断s和t是否相似,忽略大小写和标题三种格式

1
2
3
4
5
a := []byte("abc")
b := []byte("ABC")
fmt.Printf("%s, %s, %v\n", a, b, bytes.EqualFold(a, b)) // abc, ABC, true
b = []byte("ABCC")
fmt.Printf("%s, %s, %v\n", a, b, bytes.EqualFold(a, b)) // abc, ABCC, false

func Fields(s []byte) [][]byte
// 以连续空白为分隔符切割s成多个子串(不含分隔符)

1
2
3
a := []byte("abc def  ABC  CBA")
fmt.Printf("%s, %v\n", a, bytes.Fields(a))
// abc def ABC CBA, [[97 98 99] [100 101 102] [65 66 67] [67 66 65]]

func FieldsFunc(s []byte, f func(rune) bool) [][]byte
// 以符合f方法的字符为分隔符切割s成多个子串(不含分隔符)

1
2
3
f := func(r rune) bool { return r == '#'}
a := []byte("This is # and @")
fmt.Printf("%s, %q\n", a, bytes.FieldsFunc(a, f)) // This is # and @, ["This is " " and @"]

func HasPrefix(s, prefix []byte) bool
// 检测s字节切片是否以prefix开头

1
2
3
4
5
6
7
s := []byte("Hello World!")
prefix := []byte("hello")
fmt.Printf("%s, %s, %v\n", s, prefix, bytes.HasPrefix(s, prefix)) // Hello World!, hello, false
prefix = []byte("Hello")
fmt.Printf("%s, %s, %v\n", s, prefix, bytes.HasPrefix(s, prefix)) // Hello World!, Hello, true
prefix = []byte("")
fmt.Printf("%s, %s, %v\n", s, prefix, bytes.HasPrefix(s, prefix)) // Hello World!, , true

func HasSuffix(s, suffix []byte) bool
// 检测s字节切片是否以suffix结尾

1
2
3
4
5
6
7
s := []byte("Hello World!")
suffix := []byte("world!")
fmt.Printf("%s, %s, %v\n", s, suffix, bytes.HasSuffix(s, suffix)) // Hello World!, world!, false
suffix = []byte("Hello World!")
fmt.Printf("%s, %s, %v\n", s, suffix, bytes.HasSuffix(s, suffix)) // Hello World!, World!, true
suffix = []byte("")
fmt.Printf("%s, %s, %v\n", s, suffix, bytes.HasSuffix(s, suffix)) // Hello World!, , true

func Index(s, sep []byte) int
// 返回sep在s中的起始位置,如果sep不在s中则返回-1

1
2
3
4
5
6
7
8
9
s := []byte("Hello World!")
sep := []byte("Hello")
fmt.Printf("'%s' of '%s' is %d\n", sep, s, bytes.Index(s, sep)) // 'Hello' of 'Hello World!' is 0
sep = []byte("World")
fmt.Printf("'%s' of '%s' is %d\n", sep, s, bytes.Index(s, sep)) // 'World' of 'Hello World!' is 6
sep = []byte("Bob")
fmt.Printf("'%s' of '%s' is %d\n", sep, s, bytes.Index(s, sep)) // 'Bob' of 'Hello World!' is -1
sep = []byte("")
fmt.Printf("'%s' of '%s' is %d\n", sep, s, bytes.Index(s, sep)) // '' of 'Hello World!' is 0

func IndexAny(s []byte, chars string) int
// 返回chars中任意字符在s中出现的第一个位置,chars为空或找不到则返回-1.

1
2
3
4
5
6
7
8
9
10
11
s := []byte("Hello World!")
chars := "abcdefg"
fmt.Printf("%s, %s, %d\n", s, chars, bytes.IndexAny(s, chars)) // Hello World!, abcdefg, 1
chars = "aabbcc"
fmt.Printf("%s, %s, %d\n", s, chars, bytes.IndexAny(s, chars)) // Hello World!, aabbcc, -1
chars = "abcd"
fmt.Printf("%s, %s, %d\n", s, chars, bytes.IndexAny(s, chars)) // Hello World!, abcd, 10
chars = ""
fmt.Printf("%s, %s, %d\n", s, chars, bytes.IndexAny(s, chars)) // Hello World!, , -1
chars = " "
fmt.Printf("%s, %s, %d\n", s, chars, bytes.IndexAny(s, chars)) // Hello World!, , 5

func IndexByte(b []byte, c byte) int
// 同Index,sep变为c字节


func IndexFunc(s []byte, f func(r rune) bool) int
// 返回符合f方法的字符首次出现的位置,找不到则返回-1


func IndexRune(s []byte, r rune) int
// 同Index,sep变为r字符


func Join(s [][]byte, sep []byte) []byte
// 以sep为连接符将子串列表连接成一个字节串

1
2
3
s := [][]byte{{65,66},{67,68}}
sep := []byte{124,124}
fmt.Printf("%q, %s, %s\n", s, sep, bytes.Join(s, sep)) // ["AB" "CD"], ||, AB||CD

func LastIndex(s, sep []byte) int
// 查找s中最后一次出现sep的位置,找不到返回-1

1
2
3
4
5
6
7
s := []byte("abcddabcd")
sep := []byte("abc")
fmt.Printf("%s, %s, %d\n", s, sep, bytes.LastIndex(s, sep)) // abcddabcd, abc, 5
sep = []byte("bcd")
fmt.Printf("%s, %s, %d\n", s, sep, bytes.LastIndex(s, sep)) // abcddabcd, bcd, 6
sep = []byte("")
fmt.Printf("%s, %s, %d\n", s, sep, bytes.LastIndex(s, sep)) // abcddabcd, , 9

func LastIndexAny(s []byte, chars string) int
// 查找s中最后一次出现chars中任意字符的位置,找不到返回-1


func LastIndexByte(s []byte, c byte) int
// 查找s中最后一次出现c字节的位置,找不到返回-1


func LastIndexFunc(s []byte, f func(r rune) bool) int
// 查找s中符合f方法的字符位置,找不到返回-1


func Map(mapping func(r rune) rune, s []byte) []byte
// 将s中的r替换成mapping(r)返回的字符,如果mapping返回负值,则丢弃

1
2
3
4
5
6
7
8
9
10
11
rot13 := func(r rune) rune {
switch {
case r >= 'A' && r <= 'Z':
return 'A' + (r-'A'+13)%26
case r >= 'a' && r <= 'z':
return 'a' + (r-'a'+13)%26
}
return r
}
fmt.Printf("%s\n", bytes.Map(rot13, []byte("'Twas brillig and the slithy gopher...")))
// 'Gjnf oevyyvt naq gur fyvgul tbcure...

func Repeat(b []byte, count int) []byte
// 返回子串b重复count次后的串

1
fmt.Printf("%s\n", bytes.Repeat([]byte("Abc"), 3))	// AbcAbcAbc

func Replace(s, old, new []byte, n int) []byte
// 将s中的前n个old替换成new,如果n<0则替换全部

1
2
3
4
s := []byte("Bob takes you to Bob's house.")
fmt.Printf("%s\n", bytes.Replace(s, []byte("Bob"), []byte("Lily"), 0)) // Bob takes you to Bob's house.
fmt.Printf("%s\n", bytes.Replace(s, []byte("Bob"), []byte("Lily"), 1)) // Lily takes you to Bob's house.
fmt.Printf("%s\n", bytes.Replace(s, []byte("Bob"), []byte("Lily"), -1)) // Lily takes you to Lily's house.

func Runes(s []byte) []rune
// 将s转换成[]rune型


func Split(s, sep []byte) [][]byte
// 以sep作为分隔符将s拆分成多个子串。
// 如果sep为空,则将s拆分成Unicode字符列表


func SplitN(s, sep []byte, n int) [][]byte
// 同Split,但可指定拆分次数n,超出n的部分不进行拆分


func SplitAfter(s, sep []byte) [][]byte
// 同Split,但是每个子串都包含分隔符sep


func SplitAfterN(s, sep []byte, n int) [][]byte
// 同SplitAfter,但可指定拆分次数n。


func Title(s []byte) []byte
// 将s中所有单词的首字符修改为Title格式返回
// Bug: 不能很好的处理Unicode标点符号分隔的单词。


func ToLower(s []byte) []byte
// 将s中的字符全部替换成小写并返回


func ToUpper(s []byte) []byte
// 将s中的字符全部替换成大小并返回


func ToTitle(s []byte) []byte
// 将s中的字符全部替换成标题并返回


func ToLowerSpecial(c unicode.SpecialCase, s []byte) []byte
// 使用指定的映射表将 s 中的所有字符修改为小写格式返回。


func ToUpperSpecial(c unicode.SpecialCase, s []byte) []byte
// 使用指定的映射表将 s 中的所有字符修改为大写格式返回。


func ToTitleSpecial(c unicode.SpecialCase, s []byte) []byte
// 使用指定的映射表将 s 中的所有字符修改为标题格式返回。


func Trim(s []byte, cutset string) []byte
func TrimLeft(s []byte, cutset string) []byte
func TrimRight(s []byte, cutset string) []byte
// 以上方法返回去掉s两边(左边、右边)包含在cutset中字符的切片


func TrimFunc(s []byte, f func(r rune) bool) []byte
func TrimLeftFunc(s []byte, f func(r rune) bool) []byte
func TrimRightFunc(s []byte, f func(r rune) bool) []byte
// 以上方法返回去掉s两边(左边、右边)符合f方法字符的切片


func TrimPrefix(s, prefix []byte) []byte
// 去掉s的前缀prefix


func TrimSuffix(s, suffix []byte) []byte
// 去掉s的后缀suffix


func TrimSpace(s []byte) []byte
// 去掉两边的空白


func NewBuffer(buf []byte) *Buffer
// 将buf包装成bytes.Buffer对象


func NewBufferString(s string) *Buffer
// 将s转换成[]byte后,包装成bytes.Buffer对象


func NewReader(b []byte) *Reader
// 将b包装成bytes.Reader对象


Buffer结构体

1
2
3
4
5
6
7
8
9
10
11
// A Buffer is a variable-sized buffer of bytes with Read and Write methods.
// The zero value for Buffer is an empty buffer ready to use.
type Buffer struct {
buf []byte // contents are the bytes buf[off : len(buf)]
off int // read at &buf[off], write at &buf[len(buf)]
bootstrap [64]byte // memory to hold first slice; helps small buffers avoid allocation.
lastRead readOp // last read operation, so that Unread* can work correctly.

// FIXME: it would be advisable to align Buffer to cachelines to avoid false
// sharing.
}

Buffer的方法:

func (b *Buffer) Bytes() []byte
// 引用未读取部分的数据切片(不移动读取位置)


func (b *Buffer) Cap() int
// 返回缓冲区容量


func (b *Buffer) Grow(n int)
// 自动增加缓存容量,以保证有n字节的剩余空间
// 如果n<0或者无法增加容量则会报Panic


func (b *Buffer) Len() int
// 返回未读缓冲区的字节长度,b.Len()==len(b.Bytes())


func (b *Buffer) Next(n int) []byte
// 返回缓冲区中的下n个字节数据的切片,并推进读取位置(类似于返回的字节数据已经被读取)。
// 如果n大于缓冲区长度,则返回整个缓冲区数据。
// 返回的切片仅在下一次调用Read或Write方法前有效。


func (b *Buffer) Read(p []byte) (n int, err error)
// 从缓冲区读取len(p)个字节或整个缓冲区到p中,返回读取的字节数n,如果没有数据可返回,则err=io.EOF。


func (b *Buffer) ReadByte() (byte, error)
// 从缓冲区读取一个字节并返回,如果没有可返回的数据,err=io.EOF。


func (b *Buffer) ReadBytes(delim byte) (line []byte, err error)
// 从缓存中读取数据直到遇到delim时停止并返回包含delim的切片。
// 如果期间遇到错误,则返回遇到错误之前读取的数据并返回err。


func (b *Buffer) ReadFrom(r io.Reader) (n int64, err error)
// 从r中读取数据直到遇到EOF并且写入缓存区,必要时会增大缓存。
// 返回读取到的字节数量n,遇到除了EOF的其他错误也会返回结果。
// 如果缓存变的太大将会报一个ErrTooLarge的Panic错误。


func (b *Buffer) ReadRune() (r rune, size int, err error)
// 从缓存中读取并返回下一个UTF8编码字符,没有合适的字节则返回io.EOF。


func (b *Buffer) ReadString(delim byte) (line string, err error)
// 从缓存中读取直到第一次遇到delim字节,并作为string返回这个包含delim的数据。


func (b *Buffer) Reset()
// 将b重置并清空数据,如同Truncate(0)。


func (b *Buffer) String() string
// 将缓冲区所有未读数据作为string返回,如果b是nil,则返回”“。


func (b *Buffer) Truncate(n int)
// 从缓冲区中丢弃第n个未读数据之后数据,如果n<0或n>Cap则报Panic。


func (b *Buffer) UnreadByte() error
// 撤销最近一次的读操作中的最后字节数据。
// 如果在这之前执行了write或者最后一次读取返回了错误或者最后读取了空字节,则该方法会返回一个错误。


func (b *Buffer) UnreadRune() error
// 类似UnreadByte(),但是严格要求最后一次读取是Rune,否则报错。


func (b *Buffer) Write(p []byte) (n int, err error)
// 将p中的数据写入缓存,并返回写入的字节数n和可能发生的错误。


func (b *Buffer) WriteByte(c byte) error
// 往缓存中写入一个字节c并返回可能发生的错误(通常是nil)。
// 如果缓存扩容太大,则会报一个ErrTooLarge的Panic。


func (b *Buffer) WriteRune(r rune) (n int, err error)
// 同WriteByte,返回写入长度和可能发生的错误(通常是nil)。


func (b *Buffer) WriteString(s string) (n int, err error)
// 同WriteByte,将s的内容写入缓存,返回写入长度和可能发生的错误。


func (b *Buffer) WriteTo(w io.Writer) (n int64, err error)
// 将缓存数据写入w直到写入完毕或发生错误。


Buffer的示列:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
package bytes

import (
"bytes"
"fmt"
)

func Buffer(){
bt := make([]byte, 0)
buffer := bytes.NewBuffer(bt)
buffer.Write([]byte("Hello"))
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // Hello, 5, 5

buffer.WriteString(" World")
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // Hello World, 16, 11

buffer.WriteByte('!')
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // Hello World!, 16, 12

buffer.WriteRune('$')
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // Hello World!$, 16, 13

r, size, _ := buffer.ReadRune()
fmt.Printf("%q, %d\n", r, size) // 'H', 1
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // ello World!$, 16, 12

buffer.UnreadRune()
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // Hello World!$, 16, 13

b , _ :=buffer.ReadByte()
fmt.Printf("%q\n", b) // 'H'
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // ello World!$, 16, 12

buffer.UnreadByte()
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // Hello World!$, 16, 13

line, _ := buffer.ReadBytes('l')
fmt.Printf("%q\n", line) // "Hel"
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // lo World!$, 16, 10

buffer.UnreadByte()
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // llo World!$, 16, 11

str, _ := buffer.ReadString('o')
fmt.Printf("%q\n", str) // "llo"
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // World!$, 16, 8

buffer.UnreadByte()
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // o World!$, 16, 9

next := buffer.Next(2)
fmt.Printf("%q\n", next) // "o "
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // World!$, 16, 7

btRead := make([]byte, 2)
n, _ := buffer.Read(btRead)
fmt.Printf("%d\n", n) // 2
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // rld!$, 16, 5

buffer.Grow(3)
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // rld!$, 16, 5
buffer.Grow(4)
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // rld!$, 36, 5

buffer.Truncate(4)
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // rld!, 36, 4

buffer.Reset()
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // , 36, 0

bt1 := []byte("I see you.")
bf1 := bytes.NewReader(bt1)
n64, _ :=buffer.ReadFrom(bf1)
fmt.Printf("%d\n", n64) // 10
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // I see you., 584, 10

bt2 := make([]byte, 0)
bf2 := bytes.NewBuffer(bt2)
n64, _ = buffer.WriteTo(bf2)
fmt.Printf("%d, %q, %q\n", n64, bf2, bt2) // 10, "I see you.", ""
fmt.Printf("%s, %d, %d\n", buffer, buffer.Cap(), buffer.Len()) // , 584, 0
}

Reader结构体

1
2
3
4
5
6
7
8
9
10
11
// bytes.Reader 实现了如下接口:
// io.ReadSeeker
// io.ReaderAt
// io.WriterTo
// io.ByteScanner
// io.RuneScanner
type Reader struct {
s []byte
i int64 // current reading index
prevRune int // index of previous rune; or < 0
}

Reader的方法:

func (r *Reader) Len() int
// 返回未读部分的数据长度。


func (r *Reader) Size() int64
// 返回底层数据的总长度。


func (r *Reader) Reset(b []byte)
// 将底层数据切换为b,同时复位所有标记。


func (r *Reader) Read(b []byte) (n int, err error)
func (r *Reader) ReadAt(b []byte, off int64) (n int, err error)
func (r *Reader) ReadByte() (byte, error)
func (r *Reader) ReadRune() (ch rune, size int, err error)
func (r *Reader) Seek(offset int64, whence int) (int64, error)
func (r *Reader) UnreadByte() error
func (r *Reader) UnreadRune() error
func (r *Reader) WriteTo(w io.Writer) (n int64, err error)

Reader的示列:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
package bytes

import (
"bytes"
"fmt"
)

func Reader(){
b1 := []byte("你好,世界!")
b2 := []byte("Hello World!")
buf := make([]byte, 9)
rd := bytes.NewReader(b1)
n, _ := rd.Read(buf)
fmt.Printf("%q, %d, %d, %d\n", buf, rd.Len(), rd.Size(), n) // "你好,", 9, 18, 9
n, _ = rd.Read(buf)
fmt.Printf("%q, %d, %d, %d\n", buf, rd.Len(), rd.Size(), n) // "世界!", 0, 18, 9

rd.Reset(b2)
buf = make([]byte, 6)
n, _ = rd.Read(buf)
fmt.Printf("%q, %d, %d, %d\n", buf, rd.Len(), rd.Size(), n) // "Hello ", 6, 12, 6
n, _ = rd.Read(buf)
fmt.Printf("%q, %d, %d, %d\n", buf, rd.Len(), rd.Size(), n) // "World!", 0, 12, 6

rd.UnreadByte()
n, _ = rd.Read(buf)
fmt.Printf("%q, %d, %d, %d\n", buf, rd.Len(), rd.Size(), n) // "!orld!", 0, 12, 1
// UnreadByte使得最后一个字符'!'回到了rd中,在rd.Read写入buf时,则将'!'写入了buf[0]中。
}

阅读剩下更多

默认配图
编程语言

Go语言包-bufio

一天一个Golang包,慢慢学习之“bufio”

今天学习带缓存的I/O操作,基础包“bufio”中有bufio.go和scan.go两个文件

阅读文档:

官方pkg地址:https://golang.org/pkg/bufio/

包方法

func NewReadWriter(r *Reader, w *Writer) *ReadWriter
// 将r和w封装为一个bufio.Readwriter对象

func NewReader(rd io.Reader) *Reader
// 将rd封装为一个bufio.Reader对象(缓存大小默认4096)

func NewReaderSize(rd io.Reader, size int) *Reader
// 将rd封装成一个拥有size大小缓存的bufio.Reader对象

func NewScanner(r io.Reader) *Scanner
// 创建一个Scanner来扫描r

func NewWriter(w io.Writer) *Writer
// 将w封装成一个bufio.Writer对象(缓存大小默认4096)

func NewWriterSize(w io.Writer, size int) *Writer
//将w封装成一个拥有size大小缓存的bufio.Writer对象

Reader结构体

1
2
3
4
5
6
7
8
9
// Reader 实现了对io.Reader对象的缓冲功能
type Reader struct {
buf []byte
rd io.Reader // reader provided by the client
r, w int // buf read and write positions
err error
lastByte int
lastRuneSize int
}

func (b *Reader) Buffered() int
// 返回缓存中的数据长度

func (b *Reader) Discard(n int) (discarded int, err error)
// 丢弃接下来的n个字节,返回丢弃的字节长度

func (b *Reader) Peek(n int) ([]byte, error)
// 返回前n字节的缓存切片

func (b *Reader) Read(p []byte) (n int, err error)
// 读取len(p)个字节到p中。
// 如果len(p)>缓存大小,且缓存不为空,则读取全部缓存。
// 若缓存为空,则从底层io.Reader直接读取

func (b *Reader) ReadByte() (byte, error)
// 读出一个字节并返回

func (b *Reader) ReadBytes(delim byte) ([]byte, error)
// 查找delim并读取delim及其之前的所有数据(byte切片)
// 如果在找到delim之前发生错误,则返回发生错误之前的数据和error。
// 当找不到delim的时候,err!=nil

func (b *Reader) ReadLine() (line []byte, isPrefix bool, err error)
// 返回一个单行数据(切片),不包括行尾标记。
// 如果在缓存中找不到行尾标记,isPrefix为true,表示查找未完成,否则isPrefix为false

func (b *Reader) ReadRune() (r rune, size int, err error)
// 读取一个UTF8字符和字符的编码长度。
// 如果UTF8序列无法解码出一个正确的Unicode字符,则只读出一个字节,并返回U+FFFD字符,size返回1。

func (b *Reader) ReadSlice(delim byte) (line []byte, err error)
// 查找delim并读取delim及其之前的所有数据(byte切片-引用)

func (b *Reader) ReadString(delim byte) (string, error)
// 查找delim并读取delim及其之前的所有数据(字符串)

func (b *Reader) Reset(r io.Reader)
// 丢弃任何缓存数据,重置所有状态并切换io.Reader到r

func (r *Reader) Size() int
// 返回(底层)缓存的字节长度

func (b *Reader) UnreadByte() error
// 撤销最后一次读出的一个字节

func (b *Reader) UnreadRune() error
// 撤销最后一次读出的Unicode字符
// 如果最后一次执行的不是ReadRune(),则返回一个错误

func (b *Reader) WriteTo(w io.Writer) (n int64, err error)
// 实现了io.WriteTo接口。
// 可以(可能)对底层Reader的Read方法进行多次调用。
// 如果底层Reader支持WriteTo方法,则直接调用底层方法,无需缓存。

Reader的示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
package bufio

import (
"bufio"
"bytes"
"fmt"
)

func Reader(){
testB := bytes.NewReader([]byte("abcdefg\nABCDEFG\nh i j k\nH I J K\n\nline."))
bufRd := bufio.NewReader(testB)
fmt.Println(bufRd.Buffered(), bufRd.Size())
// 0 4096

b, _ := bufRd.ReadByte()
fmt.Println(bufRd.Buffered(), b, string(b))
// 37 97 a

bs, _ := bufRd.ReadBytes('d')
fmt.Println(bufRd.Buffered(), bs, string(bs))
// 34 [98 99 100] bcd

discard, _ := bufRd.Discard(1)
fmt.Println("discard:", discard, "bufferd:", bufRd.Buffered())
// discard: 1 bufferd: 33

b, _ = bufRd.ReadByte()
fmt.Println(bufRd.Buffered(), b, string(b))
// 32 102 f

bs, _ = bufRd.Peek(7)
fmt.Println(bufRd.Buffered(), bs, string(bs))
// 32 [103 10 65 66 67 68 69] g
// ABCDE

line, isPrefix, _ := bufRd.ReadLine()
fmt.Println(bufRd.Buffered(), line, string(line), isPrefix)
// 30 [103] g false

r, size, _ := bufRd.ReadRune()
fmt.Println(bufRd.Buffered(), r, string(r), size)
// 29 65 A 1

slice, _ := bufRd.ReadSlice('D')
fmt.Println(bufRd.Buffered(), slice, string(slice))
// 26 [66 67 68] BCD

str, _ := bufRd.ReadString('G')
fmt.Println(bufRd.Buffered(), str)
// 23 EFG

bufRd.Reset(bytes.NewReader([]byte("Hello World.\nMy World.")))

str, _ = bufRd.ReadString('r')
fmt.Println(bufRd.Buffered(), str)
// 13 Hello Wor

bufRd.UnreadByte()
fmt.Println(bufRd.Buffered())
// 14

str, _ = bufRd.ReadString('\n')
fmt.Println(bufRd.Buffered(), str)
// 9 rld.
//

r, size, _ = bufRd.ReadRune()
fmt.Println(bufRd.Buffered(), r, string(r), size)
// 8 77 M 1

bufRd.UnreadRune()
fmt.Println(bufRd.Buffered())
// 9

str, _ = bufRd.ReadString('\n')
fmt.Println(bufRd.Buffered(), str)
// 0 My World.

}

Writer结构体

1
2
3
4
5
6
7
8
9
// Writer 实现了对io.Writer对象的缓冲功能
// 如果在写入Writer时发生错误,则会停止继续写入和后续操作并返回这个错误。
// 在所有数据被写入后,应当调用Flush方法来保证所有数据都被写入底层Writer。
type Writer struct {
err error
buf []byte
n int
wr io.Writer
}

func NewWriter(w io.Writer) *Writer
// 将w封装成一个bufio.Writer对象,缓存大小为4096.

func NewWriterSize(w io.Writer, size int) *Writer
// 将w封装成一个拥有size大小缓存的bufio.Writer对象

func (b *Writer) Available() int
// 返回缓存中的可用空间

func (b *Writer) Buffered() int
// 返回缓存中未提交的数据长度

func (b *Writer) Flush() error
// 将缓存中的数据提交到底层io.Writer中

func (b *Writer) ReadFrom(r io.Reader) (n int64, err error)
// 实现了io.ReaderFrom接口。
// 如果底层writer支持ReadFrom方法且b的缓存数据为空,则直接调用底层的ReadFrom方法,不使用缓存。

func (b *Writer) Reset(w io.Writer)
// 丢弃所有未被提交的缓存数据,重置所有状态并切换io.Writer到w

func (b *Writer) Size() int
// 以字节为单位返回(底层)缓冲区大小

func (b *Writer) Write(p []byte) (nn int, err error)
// 将p中的数据写入b中,返回写入的字节数
// 如果写入的字节数小于p的长度,则返回错误

func (b *Writer) WriteByte(c byte) error
// 写入一个字节

func (b *Writer) WriteRune(r rune) (size int, err error)
// 写入一个UTF8编码字符

func (b *Writer) WriteString(s string) (int, error)
// 写入一个字符串,返回写入的字节数

Writer的示列:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
package bufio

import (
"bufio"
"bytes"
"fmt"
)

func Writer(){
bt := make([]byte, 0)
Bt := bytes.NewBuffer(bt)
bufWt := bufio.NewWriter(Bt)

fmt.Println(bufWt.Available(), bufWt.Buffered()) // 4096 0

// Write
nn, _ := bufWt.Write([]byte{65, 66})
fmt.Println(bufWt.Available(), bufWt.Buffered()) // 4094 2
fmt.Println(nn, Bt) // 2 "空"
bufWt.Flush()
fmt.Println(bufWt.Available(), bufWt.Buffered()) // 4096 0
fmt.Println(nn, Bt) // 2 AB

// WriteByte
bufWt.WriteByte('C')
fmt.Println(bufWt.Available(), bufWt.Buffered()) // 4095 1
fmt.Println(Bt) // AB
bufWt.Flush()
fmt.Println(bufWt.Available(), bufWt.Buffered()) // 4096 0
fmt.Println(Bt) // ABC

// WriteRune
size, _ := bufWt.WriteRune('D')
fmt.Println(bufWt.Available(), bufWt.Buffered()) // 4095 1
fmt.Println(size, Bt) // 1 ABC
bufWt.Flush()
fmt.Println(bufWt.Available(), bufWt.Buffered()) // 4096 0
fmt.Println(Bt) // ABCD

// WriteString
n, _ := bufWt.WriteString("EFG")
fmt.Println(bufWt.Available(), bufWt.Buffered()) // 4093 3
fmt.Println(n, Bt) // 3 ABCD
bufWt.Flush()
fmt.Println(bufWt.Available(), bufWt.Buffered()) // 4096 0
fmt.Println(Bt) // ABCDEFG

fmt.Println(bufWt.Size()) // 4096

// ReadFrom without buffered
some := bytes.NewReader([]byte("HIJKLMN"))
nChar, _ := bufWt.ReadFrom(some)
fmt.Println(bufWt.Available(), bufWt.Buffered()) //4096 0
fmt.Println(nChar, Bt) //7 ABCDEFGHIJKLMN
// 这里不用调用flush,因为在ReadForm之前缓存中没有数据,直接调用底层的ReadFrom写入了数据
// 下面看下有缓存的情况,先写入一个换行
bufWt.WriteByte('\n')
fmt.Println(bufWt.Available(), bufWt.Buffered()) // 4095 1
fmt.Println(Bt) // ABCDEFGHIJKLMN
// 紧接着不Flash而是直接ReadForm
some2 := bytes.NewReader([]byte("OPQRST"))
nChar, _ = bufWt.ReadFrom(some2)
fmt.Println(bufWt.Available(), bufWt.Buffered()) //4089 7
fmt.Println(nChar, Bt) //6 ABCDEFGHIJKLMN
// 现在Flush然后看各个变量
bufWt.Flush()
fmt.Println(bufWt.Available(), bufWt.Buffered()) // 4096 0
fmt.Println(Bt) // ABCDEFGHIJKLMN"换行"OPQRST
}

Scanner结构体

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
// Scanner为读取数据提供了便捷的接口,这些数据包括但不限于有换行分界符的文本文件。
// 连续调用Scan方法将会遍历文件的'Token'(指定部分)且跳过指定部分之间的字节。
// 指定部分的格式由SplitFunc类型的函数定义,默认的切分函数根据行尾将输入拆分成行但不包括行尾
// 本包下定义并提供的切分函数用于将文件扫描成line,bytes,UTF-8Encoded runes和空格拆分的单词。用户也可以使用自己的切分函数来替换它。
// 当扫描遇到EOF、第一次I/O错误或'指定部分'太大无法存入缓冲区时停止。
// 当一次扫描停止时,读取器有可能早已超出'指定部分'很远。如果程序想要对数据进行更多的控制,如错误处理或扫描更大的'指定部分'或顺序扫描,则应当使用bufio.reader来代替。
type Scanner struct {
r io.Reader // 用户提供的reader.
split SplitFunc // 拆分token的方法.
maxTokenSize int // token的上限
token []byte // split返回的最后token.
buf []byte // 作为参数给split的缓冲区.
start int // 缓冲区起始位.
end int // 缓冲区终止位.
err error // Sticky error.
empties int // 连续出现空token的次数.
scanCalled bool // 扫描是否开始.
done bool // 扫描完毕.
}

func (s *Scanner) Buffer(buf []byte, max int)
// 用于设置自定义缓存以及可扩展范围,如果max小于len(buf),则buf的尺寸将固定不可调。
// Buffer必须在第一次Scan之前设置,否则引发Panic。
// 默认情况下,Scanner将会使用一个4096-bufio.MaxScanTokenSize大小的内部缓存。

func (s *Scanner) Bytes() []byte
// 将最后一次扫描出的‘指定部分’作为切片(引用)返回
// 下一次的扫描会覆盖本结果

func (s *Scanner) Err() error
// 返回扫描过程中遇到的非EOF错误

func (s *Scanner) Scan() bool
// 扫描数据中的‘指定部分’

func (s *Scanner) Split(split SplitFunc)
// 设置Scanner的分切函数,必须在Scan方法之前调用

func (s *Scanner) Text() string
// 最后一次扫描出的‘指定部分’作为String返回

Scanner的示例:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
package bufio

import (
"bufio"
"bytes"
"fmt"
)

func Scan(){
b1 := bytes.NewReader([]byte("ABC\nDEF\r\nGHI\nJKL"))
bs := bufio.NewScanner(b1)
for bs.Scan() {
fmt.Printf("%s %v\n", bs.Bytes(), bs.Text())
}
// ABC ABC
// DEF DEF
// GHI GHI
// JKL JKL
b2 := bytes.NewReader([]byte("ABC\nDEF GHI JKL"))
bs = bufio.NewScanner(b2)
bs.Split(bufio.ScanWords)
for bs.Scan() {
fmt.Println(bs.Text())
}
// ABC
// DEF
// GHI
// JKL
b3 := bytes.NewReader([]byte("Hello 世界!"))
bs = bufio.NewScanner(b3)
bs.Split(bufio.ScanRunes)
for bs.Scan() {
fmt.Printf("%v ", bs.Text())
}
// H e l l o 世 界 !
fmt.Println()
b4 := bytes.NewReader([]byte("我的天哪!"))
bs = bufio.NewScanner(b4)
bs.Split(bufio.ScanBytes)
for bs.Scan() {
fmt.Printf("%v ", bs.Bytes())
}
// [230] [136] [145] [231] [154] [132] [229] [164] [169] [229] [147] [170] [33]
fmt.Println()
}

另外的参考:

阅读剩下更多

默认配图
编程语言

Go语言包-archive/zip

一天一个Golang包,慢慢学习之“archive/zip”

昨天阅读了archive包的tar包,对Go语言操作压缩包有了一定的基础,今天就继续把另外一个包“zip”也来熟悉一下。

阅读文档:

官方pkg地址:https://golang.org/pkg/archive/zip/

今天同样从官方的包文档中提取几个主要的内容出来分享一下:

常量

1
2
3
4
const (
Store uint16 = 0 // no compression
Deflate uint16 = 8 // DEFLATE compressed
)

变量

1
2
3
4
5
var (
ErrFormat = errors.New("zip: not a valid zip file") // 不合法的zip文件
ErrAlgorithm = errors.New("zip: unsupported compression algorithm") // 不支持的压缩算法
ErrChecksum = errors.New("zip: checksum error") //校验错误
)

FileHeader结构体

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
type FileHeader struct {
Name string // 文件名,必须是相对路径,不能以设备或斜杠开始,分隔符用'/'表示

Comment string

NonUTF8 bool // Go 1.10

CreatorVersion uint16
ReaderVersion uint16
Flags uint16

Method uint16

Modified time.Time // Go 1.10
ModifiedTime uint16 // Deprecated: Legacy MS-DOS date; use Modified instead.
ModifiedDate uint16 // Deprecated: Legacy MS-DOS time; use Modified instead.

CRC32 uint32
CompressedSize uint32 // Deprecated: Use CompressedSize64 instead.
UncompressedSize uint32 // Deprecated: Use UncompressedSize64 instead.
CompressedSize64 uint64 // Go 1.1
UncompressedSize64 uint64 // Go 1.1
Extra []byte
ExternalAttrs uint32 // Meaning depends on CreatorVersion
}

FileHeader相关的方法:

func FileInfoHeader(fi os.FileInfo) (*FileHeader, error) // 通过传入的fi填充一个FileHeader并返回,由于os.FileInfo的Name方法只返回文件描述的Name,所以实际使用有可能需要自行修改为完整的全路径

func (h *FileHeader) FileInfo() os.FileInfo // 返回一个os.FileInfo

func (h *FileHeader) ModTime() time.Time // 修改时间

func (h *FileHeader) Mode() (mode os.FileMode) // 权限和模式位

func (h *FileHeader) SetModTime(t time.Time) // 设置修改时间

func (h *FileHeader) SetMode(mode os.FileMode) // 设置权限

ReadCloser结构体

1
2
3
4
type ReadCloser struct {
Reader
// contains filtered or unexported fields
}

ReadCloser的相关方法:

func OpenReader(name string) (*ReadCloser, error) // 传入文件名(路径),返回一个ReadCloser指针(继承了Reader)

func (rc *ReadCloser) Close() error // 关闭ReadCloser

Reader结构体

1
2
3
4
5
type Reader struct {
File []*File
Comment string
// contains filtered or unexported fields
}

Reader的相关方法:

func NewReader(r io.ReaderAt, size int64) (*Reader, error) // 从r中读取size个字节并返回一个新的Reader

func (z *Reader) RegisterDecompressor(method uint16, dcomp Decompressor)

Writer结构体

1
2
3
type Writer struct {
// contains filtered or unexported fields
}

Writer的相关方法:

func NewWriter(w io.Writer) *Writer // 创建并返回一个将zip文件写入w的Writer

func (w *Writer) Close() error // 关闭Writer

func (w *Writer) Create(name string) (io.Writer, error) // 使用name添加一个文件到zip文件中,返回一个Writer。name必须是相对路径,不能以设备或斜杠开头,用’/‘作为分隔符。新增文件内容必须在下一次调用CreateHeader、Create或Close方法前全部写入。

func (w *Writer) CreateHeader(fh *FileHeader) (io.Writer, error) // 使用fh所描述的元数据添加一个文件到zip文件中,并返回一个用于写入数据的io.Writer。

func (w *Writer) Flush() error // 将缓存写入底层IO

等等..


实现一个跟昨天一样的需求:简单的创建和读取压缩包,传送门

代码实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
package zip

import (
"archive/zip"
"fmt"
"io"
"log"
"os"
"time"
)

var(
filePath = "/tmp/go/learn/data/zipArchive.zip"
)

func CreateArchive(){
fmt.Println("This is function CreateArchive called")
var files = []struct{
Name, Body string
}{
{"Readme.md", "## Hello World\n1. line 1\n2. line 2\n3. line 3"},
{"gopher.txt", "Gopher names:\nGorge\nGeoffrey\nGonzo"},
{"todo.txt", "Get animal handling licence.\nWrite more examples"},
{"myDir/file.txt", "This is a sub dir's file"},
}
fi, err := os.Create(filePath)
defer fi.Close()
if err != nil {
log.Fatal(err)
}
zw := zip.NewWriter(fi)
for _, file := range files {
fh := &zip.FileHeader{
Name: file.Name,
Modified: time.Now(),
}
// 这里也可以使用 f, err := zw.Create(file.Name); 快速创建文件
if f, err := zw.CreateHeader(fh); err != nil{
log.Fatal(err)
}else{
if _, err := f.Write([]byte(file.Body));err != nil {
log.Fatal(err)
}
}
}
if err = zw.Close(); err != nil {
log.Fatal(err)
}
fmt.Println("Created Archive file is stored in:", filePath)
}

func ReadArchive(){
fmt.Println("This is function ReadeArchive called")
zr, err := zip.OpenReader(filePath)
if err != nil {
log.Fatal(err)
}
defer zr.Close()
for _, f := range zr.File {
fmt.Printf("\tContents of %s:\n",f.Name)
if rc, err := f.Open();err != nil {
log.Fatal(err)
}else{
if _, err := io.Copy(os.Stdout, rc, ); err != nil {
log.Fatal(err)
}
rc.Close()
fmt.Println()
}
}
}

通过今天的学习,突然发现了昨天的tar并没有涉及到压缩,所以它应该就是个普通的归档,而zip中带有了压缩算法,所以它可以被称为压缩包。不过我今天也悄悄的看了一下tar.gz的相关内容,非常简单!这里就不多说,感兴趣的自行移步官方文档。

阅读剩下更多

默认配图
编程语言

Go语言包-archive/tar

一天一个Golang包,慢慢学习之“archive/tar”

今天了解一下归档(压缩包)中的tar包,我们对压缩包其实并不陌生,像是”某某.tar”,自然能想到应该用压缩包工具打开并解压出来使用。

阅读文档:

官方pkg地址:https://golang.org/pkg/archive/tar/

从官方的包文档中,我提取几个主要的内容出来分享一下:

常量

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
const (
// Type '0' indicates a regular file.(普通文件)
TypeReg = '0'
TypeRegA = '\x00' // Deprecated: Use TypeReg instead.

// Type '1' to '6' are header-only flags and may not have a data body.
TypeLink = '1' // Hard link(硬链接)
TypeSymlink = '2' // Symbolic link(软链接/符号链接)
TypeChar = '3' // Character device node(字符设备节点)
TypeBlock = '4' // Block device node(块设备节点)
TypeDir = '5' // Directory(目录)
TypeFifo = '6' // FIFO node

// Type '7' is reserved.(保留项)
TypeCont = '7'

// Type 'x' is used by the PAX format to store key-value records that
// are only relevant to the next file.
// This package transparently handles these types.
TypeXHeader = 'x' // 可扩展头部

// Type 'g' is used by the PAX format to store key-value records that
// are relevant to all subsequent files.
// This package only supports parsing and composing such headers,
// but does not currently support persisting the global state across files.
TypeXGlobalHeader = 'g' // 全局扩展头部

// Type 'S' indicates a sparse file in the GNU format.
TypeGNUSparse = 'S' // 稀疏文件

// Types 'L' and 'K' are used by the GNU format for a meta file
// used to store the path or link name for the next file.
// This package transparently handles these types.
TypeGNULongName = 'L'
TypeGNULongLink = 'K'
)

变量(主要用于错误输出)

1
2
3
4
5
6
var (
ErrHeader = errors.New("archive/tar: invalid tar header") // 无效的tar头部
ErrWriteTooLong = errors.New("archive/tar: write too long") // 写入数据太长
ErrFieldTooLong = errors.New("archive/tar: header field too long") // 头部太长
ErrWriteAfterClose = errors.New("archive/tar: write after close") // 关闭后写入
)

Header结构体

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
type Header struct {
Typeflag byte // the type of header entry.(文件类型)

Name string // 文件名称
Linkname string // 链接名称 (适用于硬链接和软链接)

Size int64 // 文件的字节大小
Mode int64 // 权限,如:0600
Uid int // 用户ID
Gid int // 组ID
Uname string // 用户名
Gname string // 组名

ModTime time.Time // 最后一次修改文件或目录的时间
AccessTime time.Time // 最后一次访问文件或目录的时间
ChangeTime time.Time // 最后一次改变文件或目录(改变的是原数据即:属性)的时间

Devmajor int64 // Major device number (valid for TypeChar or TypeBlock)(字符设备或块设备的主设备号)
Devminor int64 // Minor device number (valid for TypeChar or TypeBlock)(字符设备或块设备的次设备号)

Xattrs map[string]string // Go 1.3

PAXRecords map[string]string // Go 1.10

Format Format // Go 1.10
}

Header的相关方法:

func FileInfoHeader(fi os.FileInfo, link string)(*Header, error) //该方法通过os.FileInfo来创建一个tar.Header,用在对已有文件打包十分方便

func (h *Header) FileInfo() os.FileInfo // 该方法获取Header的os.FileInfo信息

Reader结构体

1
2
3
4
5
6
7
8
9
10
11
type Reader struct {
r io.Reader
pad int64 // Amount of padding (ignored) after current file entry
curr fileReader // Reader for current file entry
blk block // Buffer to use as temporary local storage

// err is a persistent error.
// It is only the responsibility of every exported method of Reader to
// ensure that this error is sticky.
err error
}

Reader结构体有以下方法:
func NewReader(r io.Reader) *Reader // 用r创建新的tar.Reader

func (tr *Reader) Next() (*Header, error) // 使tr指向下一个文件实体并返回实体的Header,到最后会返回err为io.EOF

func (tr *Reader) Read(b []byte) (int, error) // 读取当前实体到b,读取到最后时返回err为io.EOF

阅读到这儿,基本就可以解析一个tar文件了,从上述的方法我们可以得知,要想获得压缩包的内容,我们可以使用tar.Reader来完成,而tar.Reader的创建可以通过使用tar.NewReader()方法,该方法需要提供一个实现了io.Reader接口的对象,此对象可以通过os包的方法如os.Open()或者os.OpenFile()等方法获得。根据这个思路,我们便可以解析获得tar文件的所有内容了。

Writer结构体

1
2
3
4
5
6
7
8
9
10
11
12
type Writer struct {
w io.Writer
pad int64 // Amount of padding to write after current file entry
curr fileWriter // Writer for current file entry
hdr Header // Shallow copy of Header that is safe for mutations
blk block // Buffer to use as temporary local storage

// err is a persistent error.
// It is only the responsibility of every exported method of Writer to
// ensure that this error is sticky.
err error
}

Writer结构体有如下方法:
func NewWriter(w io.Writer) *Writer // 用w创建新的tar.Writer

func (tw *Writer) Close() error // 关闭tar文件,并将未写入的数据写入底层writer
func (tw *Writer) Flush() error // 完成当前写入

func (tw *Writer) Write(b []byte) (int, error) // 将b写入当前实体,如果写入长度大于WriteHeader所描述的Size,则会返回err为ErrWriteTooLong的报错

func (tw *Writer) WriteHeader(hdr *Header) error // 将hdr写入tar文件中并准备接受Write()方法的写入,hdr.Size决定写入的文件字节大小。如果未完全写入,则会报错。写入hdr之前会隐式调用Flash()。

下面我们假设这样一个需求:

需求描述:

  1. 创建一个压缩包文件,命名为:”tarArchive.tar”。
  2. 压缩包中存有3个文本文档,分别命名:”readme.md”、”gopher.txt”、”todo.txt”,内容随意。
  3. 压缩包中还有一个目录(命名:dir),其中有一个文件:dirFile.txt,内容随意
  4. 将压缩包保存在”/tmp/go/learn/data”目录中。
  5. 读取压缩包内容,并打印文件(或目录)以及文件内容。

求解过程:

  1. 最终结果是要创建一个文件,所以我们先创建这个文件:这里用到f, err := os.OpenFile()方法来获取一个文件指针
  2. 然后创建一个tar的Writer对象来实现对文件的写入:tw := tar.NewWriter(f),获得的tw对象就是一个写入器,他有Write方法。
  3. 构建一个文件列表(任何方式,为了方便用循环添加文件)。
  4. 使用tw.WriteHeader()tw.Write()方法向压缩包写入文件。
  5. 关闭文件和写入器:f.Close()tw.Close(),tar文件创建完毕。
  6. 读取tar文件,并使用tar.NewReader()获得Reader对象。
  7. 循环Next()方法获得hdr并打印hdr.Name以及Reader的内容
  8. 判断io.EOF结束并关闭文件。

完整代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
package tar

import (
"archive/tar"
"fmt"
"io"
"log"
"os"
)
var(
filePath = "/tmp/go/learn/data/tarArchive.tar"
)

func CreateArchive(){
f, err := os.OpenFile(filePath, os.O_CREATE|os.O_WRONLY|os.O_TRUNC, 0666)
if err != nil {
log.Fatal(err)
}
defer f.Close()
tw := tar.NewWriter(f)
var files = []struct{
Name, Body string
}{
{"Readme.md", "This is a readme markdown file."},
{"gopher.txt", "Gopher names:\nGeorge\nGeoffrey\nGonzo"},
{"todo.txt", "Get animal handling license."},
{"dir/dirFile.txt", "it's content is in directory"},
}
// 创建一个名字叫做myDir2的目录,用于区分上述的dir/dirFile.txt中的目录
if err = tw.WriteHeader(&tar.Header{Name: "myDir2",Mode: 0766,Typeflag:tar.TypeDir}); err != nil{
log.Fatal(err)
}
for _, file := range files {
hdr := &tar.Header{
Name: file.Name,
Mode: 0600,
Size: int64(len(file.Body)),
}
if err := tw.WriteHeader(hdr); err != nil {
log.Fatal(err)
}
if _, err := tw.Write([]byte(file.Body)); err != nil {
log.Fatal(err)
}
}
if err := tw.Close(); err != nil {
log.Fatal(err)
}
}

func ReadArchive(){
f, err := os.OpenFile(filePath, os.O_RDONLY, 0)
if err != nil {
log.Fatal(err)
}
defer f.Close()
tr := tar.NewReader(f)
for {
hdr, err := tr.Next()
if err == io.EOF {
break
}
if err != nil {
log.Fatal(err)
}
fmt.Printf("Contents of %s:\n",hdr.Name)
if _, err := io.Copy(os.Stdout, tr); err != nil {
log.Fatal(err)
}
fmt.Println("\n====")
}
}

注意:代码中有关myDir目录和myDir2目录的创建方式不一样,但是效果差异不大

阅读剩下更多

默认配图
学习笔记

判断IP地址是否内网IP

当你的服务同时开放于公网和内网,子服务却仅允许内网访问,那么则会涉及到IP白名单的功能。但是如果名单太多或者服务进行了迁移,那么维护起来会相当的麻烦,最简单的就是判断访问的来源IP是否内网IP地址,从而直接屏蔽掉公网IP。

首先,我们认识了3类私有地址:

A类:10.0.0.0-10.255.255.255

B类:172.16.0.0-172.31.255.255

C类:192.168.0.0-192.168.255.255

还有一个本机地址:127.0.0.1

他们就是我们平时所谓的内网IP地址。

方法一: PHP自带函数

filter_var($IP, FILTER_VALIDATE_IP, FILTER_FLAG_NO_PRIV_RANGE | FILTER_FLAG_NO_RES_RANGE)

如果$IP是内网IP则会返回false,否则返回ip字符串。

1
2
3
4
5
6
7
$IP = get_client_ip(); //该方法自己实现,返回客户端的IP地址
$is_publicIP = filter_var($IP, FILTER_VALIDATE_IP, FILTER_FLAG_NO_PRIV_RANGE | FILTER_FLAG_NO_RES_RANGE);
if($is_publicIP){
echo '公网IP';
}else{
echo '内网IP';
}

方法二: 适合有网络基础的胖友阅读

关于IP地址的知识,这里就不讲太多了,下面的方法就是根据IP地址的定义和网段的划分等专业知识进行判定的。懂的就自然懂啦!

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
<?php
function isLocal($ip){
$long=ip2long($ip);
$data=array(
24=>'10.255.255.255',
20=>'172.31.255.255',
16=>'192.168.255.255'
);
foreach($data as $k=>$v){
if($long >> $k === ip2long($v)>>$k){
return true;
}
}
return false;
}

方法三:正则匹配

更加不用解释了。

1
2
3
4
<?php
function isLocal($ip){
return preg_match('%^127\.|10\.|192\.168|172\.(1[6-9]|2|3[01])%',$ip);
}

参考:

  1. http://php.net/manual/zh/function.filter-var.php
  2. https://www.51-n.com/t-4360-1-1.html
  3. https://blog.csdn.net/z_qifa/article/details/75497577

阅读剩下更多

默认配图
学习笔记

更新升级MacOSX到10.14 Mojave (MacBook Air 13-inch early 2014)

写在前面的话:

如果不是真的很需要,其实最好是不去更新系统,以免带来更多的麻烦。如果新的系统对你真的很重要,我也建议你备份现有数据,然后全新安装新的系统版本。我就是那个单纯的升级系统,导致原有的软件无法正常运行的傻逼,下面虽然记录了我的问题,但我最终的解决方案还是把软件卸载后重新安装和配置。

既然App Store推送了本次更新,我也就傻傻的更新了,谁知道会发生什么呢?

很不开心的是,第二天上班来发现系统更新好了,直接登录!一切安好。然鹅!!!发现了好几个惊喜:

  1. svn和git命令无法执行,提示xcrun: error: invalid active developer path (/Library/Developer/CommandLineTools), missing xcrun at: /Library/Developer/CommandLineTools/usr/bin/xcrun
  2. Apache和PHP配置全部恢复成初始状态,所有已安装的扩展没了
  3. OSSRS(Simple-RTMP-Server)无法运行了,提示:illegal hardware instruction,目前没找到解决方案,提了Issue看怎么说。

解决第一个问题网上给了答案,安装XCode开发者工具就好了:
xcode-select --install

Apache和PHP的配置的恢复,主要是指httpd.conf的覆盖和php.ini的丢失,以及PHP扩展丢失,这样我就不得不重新编写配置文件和编译安装开发所需要的全部扩展了。

这里记录一下我的操作过程,因为之前更新系统也遇到这种问题,但是没有做笔记,导致现在又遇到问题时又花了很多时间去找资料。

安装Memcache扩展

从Github直接clone下来:https://github.com/websupport-sk/pecl-memcache

执行phpize出现问题:

1
2
3
4
5
6
7
grep: /usr/include/php/main/php.h: No such file or directory
grep: /usr/include/php/Zend/zend_modules.h: No such file or directory
grep: /usr/include/php/Zend/zend_extensions.h: No such file or directory
Configuring for:
PHP Api Version:
Zend Module Api No:
Zend Extension Api No:

百度出来的解决方案:

1
sudo ln -s /Applications/Xcode.app/Contents/Developer/Platforms/MacOSX.platform/Developer/SDKs/MacOSX10.11.sdk/usr/include/ /usr/include

好的,遇到了就算使用sudo还是提示权限不足的情况。 不怕,之前有经验,需要关掉系统的保护机制。操作方法就是重启电脑,按住command+R直到进入新界面,通过实用工具打开终端,输入csrutil disable关闭保护,然后reboot重启

重启完打开终端,傻傻的执行ln命令后发现还是不行!phpize依旧报错, 怪我有点笨,然后才去读这行命令的意思,发现MacOSX10.11.sdk这个目录不存在,只有一个MacOSX10.14.sdk的目录。很傻,根据自己的系统来嘛!

所以下面的完整命令解决phpize的问题

1
sudo ln -s /Applications/Xcode.app/Contents/Developer/Platforms/MacOSX.platform/Developer/SDKs/MacOSX10.14.sdk/usr/include/ /usr/include

然后是./configure 接着make && sudo make install

执行完后再修改/etc/php.ini增加extension=memcache.so。然后重启apache:sudo apachectl -k restart

安装mcrypt扩展

这个我是直接去php官网下载系统当前版本的PHP源码(php-7.1.19.tar.gz),然后解压进入ext/mcrypt目录,如上所述的执行phpize./configure以及make && sudo make install,修改php.ini增加extension=mcrypt.so。重启apache搞定。

重启打开安全策略csrutil enable

电脑重启后发现memcache和mcrypt扩展无法加载,提示了文件签名的问题。无解!

所以,重点强调!!! 直接舍弃系统自带的PHP和Apache吧,用brew全新安装一个,管理起来也非常的方便,系统更新后也不会导致软件丢失!

不过,遇到了新的问题,brew在安装cmake的时候出现了错误,提示如下:

1
2
3
4
Error: You are using macOS 10.14.
We do not provide support for this pre-release version.
You may encounter build failures or other breakages.
Please create pull-requests instead of filing issues.

很明显,说当前系统版本时预发布版本,他们不支持,不支持!!??

百度了,无解,无奈就去问了Google,然后说要去下载Command Line Tools (macOS 10.14) for Xcode 10,原文:https://intellij-support.jetbrains.com/hc/en-us/community/posts/360000898980-CMake-not-compiling-after-macOS-10-14-Mojave-update

写在最后

官宣,作为一个需要稳定开发环境的开发人员和开发机器来说,不是闲的蛋疼就别随便的更新系统了吧,一个上午就折腾这事儿去了,真是满脸的不愉快,晚上8点还在重装软件,今儿可是1024啊,过节啊!!

阅读剩下更多

默认配图
学习笔记

Linux下的安装Ngrok服务器的故事

使用场景

公司A是一家服务提供商,公司B是一家知名企业。
现在公司B中的一个软件服务出现了故障,需要公司A的专业人员来排查。由于两家公司相隔甚远,他们采用了远程排查方案。但是公司B的这个软件部署在内网环境的机器C上,层层网关以及种种原因(和谐部分)导致无法将机器C映射到公司B的公网端口。为了解决这种需要打通从一个局域网到另外一个局域网的网络通路,我们叫它‘内网穿透’。

总所周知,处在同一个局域网的所有机器是可以互通的,而不同局域网中的机器是无法跨域访问的。解决这种问题,我能想到的有:

  1. 交换机和路由
  2. 使用公网VPN服务器
  3. 使用内网穿透服务器

配置交换机和路由往往非常复杂,遇到复杂的组网环境,还是杀了我吧!

公网VPN服务器我也试过了,使用简单,但是稳定性得不到保证。

所以我最终尝试了内网穿透服务器:Ngrok。(当然还有别的比如:frp)

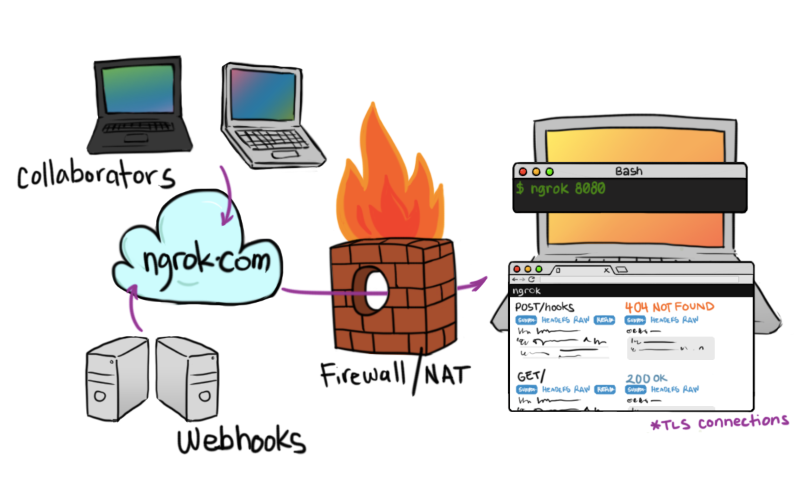
Ngrok简介

Ngrok是一款使用GO语言开发的开源软件(仅针对1.x,2.x不开源),是一个反向代理软件。它可以在你本地运行的服务和公网服务器端点建立一条安全的隧道,这样任何一个和公网连通的客户端都可以访问和使用你的本地服务。Ngrok还可以捕获和分析所有通道上的流量,对后期的分析和处理也有相当好的支持。

Ngrok的git仓库地址:https://github.com/inconshreveable/ngrok

需要的宝贝

云服务器(有公网IP的服务器)

提供这种服务的像阿里云/腾讯云/百度云等等,随便挑

域名

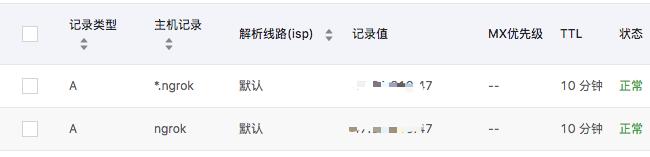
随便什么域名,只要是你的域名,你能对其配置解析(最好能泛解析)。

我的域名解析

环境要求

Linux服务器:CentOS、Ubuntu

1
2
3
4
5
#centos
yum -y install zlib-devel openssl-devel perl hg cpio expat-devel gettext-devel curl curl-devel perl-ExtUtils-MakeMaker hg wget gcc gcc-c++ git golang

#ubuntu
#自行对应缺啥用'apt-get'补啥,openssl golang make 等等的都得有

安装服务器

克隆Ngrok到本地

1
git clone https://github.com/inconshreveable/ngrok.git

制作和生成证书

1
2
3
4
5
6
7
8
9
cd ngrok
mkdir cert
cd cert
NGROK_DOMAIN="ngrok.imsry.cn"
openssl genrsa -out base.key 2048
openssl req -new -x509 -nodes -key base.key -days 10000 -subj "/CN=$NGROK_DOMAIN" -out base.pem
openssl genrsa -out server.key 2048
openssl req -new -key server.key -subj "/CN=$NGROK_DOMAIN" -out server.csr
openssl x509 -req -in server.csr -CA base.pem -CAkey base.key -CAcreateserial -days 10000 -out server.crt

覆盖证书到Ngrok中

1
2
3
cp base.pem ../ngrok/assets/client/tls/ngrokroot.crt
cp server.crt ../ngrok/assets/server/tls/snakeoil.crt
cp server.key ../ngrok/assets/server/tls/snakeoil.key

编译生成Ngrok服务端

1
2
cd ../ngrok
GOOS=linux GOARCH=amd64 make release-server

启动和运行服务端(可以写成bash脚本)

1
2
3
4
5
6
7
./bin/ngrokd -tlsKey="assets/server/tls/snakeoil.key" -tlsCrt="assets/server/tls/snakeoil.crt" -domain="ngrok.imsry.cn"  -httpAddr=":8081" -httpsAddr=":8082" -tunnelAddr=":8083"

#参数说明:
#-domain 访问ngrok是所设置的服务地址生成证书时那个
#-httpAddr http协议端口 默认为80
#-httpsAddr https协议端口 默认为443 (可配置https证书)
#-tunnelAddr 通道端口 默认4443

客户端的编译和使用

1
2
3
4
5
6
7
8
9
10
11
#window-64bit如下:
GOOS=windows GOARCH=amd64 make release-client
#编译成功后会在ngrok/bin/下面生成一个windows_amd64目录下面有ngrok.exe

#Linux 平台 32 位系统:GOOS=linux GOARCH=386
#Linux 平台 64 位系统:GOOS=linux GOARCH=amd64
#Windows 平台 32 位系统:GOOS=windows GOARCH=386
#Windows 平台 64 位系统:GOOS=windows GOARCH=amd64
#MAC 平台 32 位系统:GOOS=darwin GOARCH=386
#MAC 平台 64 位系统:GOOS=darwin GOARCH=amd64
#ARM 平台:GOOS=linux GOARCH=arm

编写配置文件ngrok.cfg

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
server_addr: "ngrok.imsry.cn:8083"
trust_host_root_certs: false

tunnels:
http:
subdomain: "test"
proto:
http: "80"

https:
subdomain: "test"
proto:
https: "443"

tcp:
remote_port: 5555
proto:
tcp: "8001"

ssh:
remote_port: 2222
proto:
tcp: "22"

启动客户端

1
2
3
4
./ngrok -config=ngrok.cfg start-all #启动所有服务

./ngrok -config=ngrok.cfg start ssh #启动SSH服务
./ngrok -config=ngrok.cfg start ssh http #启动SSH和HTTP服务

出现下面内容,表示链接成功:

1
2
3
4
5
6
7
8
9
10
11
ngrok

Tunnel Status online
Version 1.7/1.7
Forwarding http://test.ngrok.imsry.cn8081 -> 127.0.0.1:80
Forwarding https://test.ngrok.imsry.cn:8082 -> 127.0.0.1:443
Forwarding tcp://test.ngrok.imsry.cn:5555 -> 127.0.0.1:8001
Forwarding tcp://test.ngrok.imsry.cn:2222 -> 127.0.0.1:22
Web Interface 127.0.0.1:4040
# Conn 0
Avg Conn Time 0.00ms

开始访问你的服务吧!

直接访问上面的地址就能取得相应的服务
如果是ssh和tcp的话,直接使用如:ssh [email protected] -p 2222

阅读剩下更多

默认配图
编程语言

不同语言下文件读取和排序测试

排序时间对比图

测试机器配置:

  • MacBook Air (13-inch, Early 2014)
  • 处理器:1.4 GHz Intel Core i5
  • 内存:4 GB 1600 MHz DDR3

PHP

1
2
3
PHP 7.1.16 (cli) (built: Mar 31 2018 02:59:59) ( NTS )
Copyright (c) 1997-2018 The PHP Group
Zend Engine v3.1.0, Copyright (c) 1998-2018 Zend Technologies
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
<?php
$t1 = microtime(true);

$fileName = "Data.txt";
if(($file=fopen($fileName,'r')) === false){
echo '读取文件:'.$fileName."失败\n";
exit;
}
if(empty($file)){
echo "文件为空!\n";
exit;
}
$data = array();
while(!feof($file)){
$lineStr = fgets($file);
array_push($data, trim($lineStr));
}
$t2 = microtime(true);
echo 'Read time:' . ($t2 - $t1)*1000 . "ms\n";
BubbleSort($data);
var_dump($data);
fclose($file);

$t3 = microtime(true);

echo 'Sort time:' . ($t3 - $t2)*1000 . "ms\n";
echo 'Finished time:' . ($t3 - $t1)*1000 . "ms\n";

function BubbleSort(&$data){
$len = count($data);
for($i=0;$i<$len;$i++){
$flag = 0;
for($j=1;$j<($len-$i);$j++){
if($data[$j]<$data[$j-1]) {
$tmp = $data[$j];
$data[$j] = $data[$j-1];
$data[$j-1] = $tmp;
$flag = 1;
}
}
if($flag == 0){
return;
}
}
}
?>

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
~/Sites/languageDiff/sort » php sort.php
Read time:20.021915435791ms
Sort time:219256.12616539ms
Finished time:219276.14808083ms
-------------------------------------------------------
~/Sites/languageDiff/sort » php sort.php
Read time:19.091129302979ms
Sort time:229677.68502235ms
Finished time:229696.77615166ms
-------------------------------------------------------
~/Sites/languageDiff/sort » php sort.php
Read time:21.70205116272ms
Sort time:228220.97086906ms
Finished time:228242.67292023ms
-------------------------------------------------------
~/Sites/languageDiff/sort » php sort.php
Read time:20.930051803589ms
Sort time:206329.57100868ms
Finished time:206350.50106049ms
-------------------------------------------------------
~/Sites/languageDiff/sort » php sort.php
Read time:18.213033676147ms
Sort time:201813.07411194ms
Finished time:201831.28714561ms

Java

1
2
3
java version "10.0.1" 2018-04-17
Java(TM) SE Runtime Environment 18.3 (build 10.0.1+10)
Java HotSpot(TM) 64-Bit Server VM 18.3 (build 10.0.1+10, mixed mode)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
import java.io.BufferedReader;
import java.io.FileNotFoundException;
import java.io.FileReader;
import java.io.IOException;

public class sort {

public static void main(String[] args) {
try {
long t1 = System.currentTimeMillis();
int[] data = new int[50000];
BufferedReader br = new BufferedReader(new FileReader("Data.txt"));

String line = null;
int index = 0;
while ((line = br.readLine()) != null) {
data[index] = Integer.parseInt(line);
index++;
}
if (br != null) {
br.close();
}
long t2 = System.currentTimeMillis();
System.out.println("Read time: " + String.valueOf(t2 - t1) + "ms");

BubbleSort(data);
long t3 = System.currentTimeMillis();
System.out.println("Sort time: " + String.valueOf(t3 - t2) + "ms");
System.out.println("Finished time: " + String.valueOf(t3 - t1) + "ms");
} catch (FileNotFoundException e) {
e.printStackTrace();
} catch (IOException e) {
e.printStackTrace();
}
}

public static void BubbleSort(int[] a) {
int j, flag;
int temp;
for (int i = 0; i < a.length; i++) {
flag = 0;
for (j = 1; j < a.length - i; j++) {
if (a[j] < a[j-1]) {
temp = a[j];
a[j] = a[j - 1];
a[j - 1] = temp;
flag = 1;
}
}
if (flag == 0) {
return;
}
}
}
}

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
~/Sites/languageDiff/sort » java sort
Read time: 56ms
Sort time: 5286ms
Finished time: 5342ms
-------------------------------------------------------
~/Sites/languageDiff/sort » java sort
Read time: 47ms
Sort time: 4911ms
Finished time: 4958ms
-------------------------------------------------------
~/Sites/languageDiff/sort » java sort
Read time: 46ms
Sort time: 4903ms
Finished time: 4949ms
-------------------------------------------------------
~/Sites/languageDiff/sort » java sort
Read time: 47ms
Sort time: 4953ms
Finished time: 5000ms
-------------------------------------------------------
~/Sites/languageDiff/sort » java sort
Read time: 49ms
Sort time: 5335ms
Finished time: 5384ms

Go

1
go version go1.10.3 darwin/amd64
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
package main

import (
"bufio"
"fmt"
"io"
"os"
"strconv"
"time"
)

func main() {
fileName := "Data.txt"
data := make([]int, 0, 50000)
start := time.Now()
fi, err := os.Open(fileName)
if err != nil {
fmt.Printf("Error: %s\n", err)
return
}
defer fi.Close()
br := bufio.NewReader(fi)
for {
a, _, c := br.ReadLine()
if c == io.EOF {
break
}
num, _ := strconv.Atoi(string(a))
data = append(data, num)
}
endReadTime := time.Now()
fmt.Printf("Read time: %fs\n", endReadTime.Sub(start).Seconds())
BubbleSort(data)
endTime := time.Now()
fmt.Printf("Sort time: %fs\n", endTime.Sub(endReadTime).Seconds())
fmt.Printf("finished time: %fs\n", endTime.Sub(start).Seconds())
}

func BubbleSort(arr []int) {
length := len(arr)
var flag int
var tmp int
for i := 0; i < length; i++ {
flag = 0
for j := 1; j < (length - i); j++ {
if arr[j] < arr[j-1] {
tmp = arr[j]
arr[j] = arr[j-1]
arr[j-1] = tmp
flag = 1
}
}
if flag == 0 {
return
}
}
}

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
~/Sites/languageDiff/sort » go build sort.go
~/Sites/languageDiff/sort » ./sort
Read time: 0.006603s
Sort time: 5.207361s
finished time: 5.213964s
-------------------------------------------------------
~/Sites/languageDiff/sort » ./sort
Read time: 0.005319s
Sort time: 5.167615s
finished time: 5.172934s
-------------------------------------------------------
~/Sites/languageDiff/sort » ./sort
Read time: 0.005648s
Sort time: 5.317512s
finished time: 5.323160s
-------------------------------------------------------
~/Sites/languageDiff/sort » ./sort
Read time: 0.005842s
Sort time: 5.267731s
finished time: 5.273573s
-------------------------------------------------------
~/Sites/languageDiff/sort » ./sort
Read time: 0.005585s
Sort time: 5.442154s
finished time: 5.447738s

JavaScript(NodeJS)

1
2
~/Sites » node -v
v9.11.1
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
var t1 = (new Date()).getTime();  
var readline = require('readline');
var fs = require('fs');
var os = require('os');

var fReadName = './data.txt';
var fRead = fs.createReadStream(fReadName);


var objReadline = readline.createInterface({
input: fRead,
});


var data = [];
objReadline.on('line', (line)=>{
data.push(Number(line));
});

objReadline.on('close', ()=>{
var t2 = (new Date()).getTime();
console.log("Read time:" + (t2 - t1) + "ms");
var res = BubbleSort(data);
// console.log(res);
var t3 = (new Date()).getTime();
console.log("Sort time:" + (t3 - t2) + "ms");
console.log("finished time:" + (t3 - t1) + "ms");
});

function BubbleSort(arr){
for (var i = 0; i < arr.length; i++) {
var flag = 0;
for(var j = 1;j< arr.length-i;j++){
if(arr[j]<arr[j-1]){
var tmp = arr[j];
arr[j] = arr[j-1]
arr[j-1] = tmp
flag = 1;
}
}
if(flag == 0){
return arr;
}
}
return arr;
}

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
~/Sites/languageDiff/sort » node sort.js
Read time:55ms
Sort time:6067ms
finished time:6122ms
-------------------------------------------------------
~/Sites/languageDiff/sort » node sort.js
Read time:38ms
Sort time:6064ms
finished time:6102ms
-------------------------------------------------------
~/Sites/languageDiff/sort » node sort.js
Read time:37ms
Sort time:6339ms
finished time:6376ms
-------------------------------------------------------
~/Sites/languageDiff/sort » node sort.js
Read time:42ms
Sort time:6367ms
finished time:6409ms
-------------------------------------------------------
~/Sites/languageDiff/sort » node sort.js
Read time:40ms
Sort time:7110ms
finished time:7150ms

Python

1
2
~/Sites » python -V
Python 2.7.10
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
import time

def BubbleSort(a):
length = len(a)
for i in range(0,length):
flag = 0
for j in range(1,length-i):
if a[j] < a[j-1]:
tmp = a[j]
a[j] = a[j-1]
a[j-1] = tmp
flag = 1
if flag == 0:
return a


t1 = time.time()
fileName = "Data.txt"
data = []
for line in open(fileName):
data.append(int(line.strip()))
t2 = time.time()
print 'Read time: %.02fs' % (t2 - t1)
res = BubbleSort(data)
t3 = time.time()
print 'Sort time: %.02fs' % (t3 - t2)
print 'finished time: %.02fs' % (t3 - t1)

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
-------------------------------------------------------
~/Sites/languageDiff/sort » python sort.py
Read time: 0.05s
Sort time: 282.76s
finished time: 282.82s
-------------------------------------------------------
~/Sites/languageDiff/sort » python sort.py
Read time: 0.07s
Sort time: 263.54s
finished time: 263.61s
-------------------------------------------------------
~/Sites/languageDiff/sort » python sort.py
Read time: 0.06s
Sort time: 346.26s
finished time: 346.32s
-------------------------------------------------------
~/Sites/languageDiff/sort » python sort.py
Read time: 0.06s
Sort time: 298.12s
finished time: 298.18s
-------------------------------------------------------
~/Sites/languageDiff/sort » python sort.py
Read time: 0.06s
Sort time: 251.43s
finished time: 251.49s

目前这几种编程语言看来,排序如下:IO时长,排序时长,总时长

  1. Java 平均 0.0490s 5.078s 5.127s
  2. Go 平均 0.0058s 5.281s 5.286s
  3. NodeJs 平均 0.0424s 6.389s 6.432s
  4. PHP 平均 0.0200s 217.059s 217.079s
  5. Python 平均 0.0600s 288.422s 288.484s

Ps: 如果你希望看到自己喜欢的语言也排进来,欢迎提供代码!

阅读剩下更多

不同语言下文件读取和排序测试
编程语言

不同语言对网络IO的效率对比

网络IO时间对比图

测试机器配置:

  • MacBook Air (13-inch, Early 2014)
  • 处理器:1.4 GHz Intel Core i5
  • 内存:4 GB 1600 MHz DDR3

PHP

1
2
3
PHP 7.1.16 (cli) (built: Mar 31 2018 02:59:59) ( NTS )
Copyright (c) 1997-2018 The PHP Group
Zend Engine v3.1.0, Copyright (c) 1998-2018 Zend Technologies
1
2
3
4
5
6
7
8
9
10
11
12
13
14
<?php
$t1 = microtime(true);

for($i=0; $i<20; $i++){
$url = "http://2018.ip138.com/ic.asp?count=".$i;
$data = file_get_contents($url);
// echo 'get:'.$i." ".$data."\r\n";
}

$t2 = microtime(true);

echo 'php time:' . ($t2 - $t1)*1000 . "ms\n";

?>

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
~/Sites/languageDiff/io » php main.php
php time:2112.9629611969ms
-------------------------------------------------------
~/Sites/languageDiff/io » php main.php
php time:1960.746049881ms
-------------------------------------------------------
~/Sites/languageDiff/io » php main.php
php time:2055.7940006256ms
-------------------------------------------------------
~/Sites/languageDiff/io » php main.php
php time:2052.6430606842ms
-------------------------------------------------------
~/Sites/languageDiff/io » php main.php
php time:1990.2958869934ms

Java

1
2
3
java version "10.0.1" 2018-04-17
Java(TM) SE Runtime Environment 18.3 (build 10.0.1+10)
Java HotSpot(TM) 64-Bit Server VM 18.3 (build 10.0.1+10, mixed mode)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
public class Main {

public static void main(String[] args) {
long t1 = System.currentTimeMillis();

for(int i=0; i<20; i++){
String s=HttpRequest.sendGet("http://2018.ip138.com/ic.asp", "count="+i);
// System.out.println(""+i+" : "+s);
}

long t2 = System.currentTimeMillis();

System.out.println("java time: " + String.valueOf(t2 - t1) + "ms");
}
}

HttpRequst.java CodeOrigin:https://www.cnblogs.com/guoyinli/p/7192839.html

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124

import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.io.PrintWriter;
import java.net.URL;
import java.net.URLConnection;
import java.util.List;
import java.util.Map;

public class HttpRequest {
/**
* 向指定URL发送GET方法的请求
*
* @param url
* 发送请求的URL
* @param param
* 请求参数,请求参数应该是 name1=value1&name2=value2 的形式。
* @return URL 所代表远程资源的响应结果
*/
public static String sendGet(String url, String param) {
String result = "";
BufferedReader in = null;
try {
String urlNameString = url + "?" + param;
URL realUrl = new URL(urlNameString);
// 打开和URL之间的连接
URLConnection connection = realUrl.openConnection();
// 设置通用的请求属性
connection.setRequestProperty("accept", "*/*");
connection.setRequestProperty("connection", "Keep-Alive");
connection.setRequestProperty("user-agent",
"Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.1;SV1)");
// 建立实际的连接
connection.connect();
// 获取所有响应头字段
Map<String, List<String>> map = connection.getHeaderFields();
// 遍历所有的响应头字段
/*for (String key : map.keySet()) {
System.out.println(key + "--->" + map.get(key));
}*/
// 定义 BufferedReader输入流来读取URL的响应
in = new BufferedReader(new InputStreamReader(
connection.getInputStream()));
String line;
while ((line = in.readLine()) != null) {
result += line;
}
} catch (Exception e) {
System.out.println("发送GET请求出现异常!" + e);
e.printStackTrace();
}
// 使用finally块来关闭输入流
finally {
try {
if (in != null) {
in.close();
}
} catch (Exception e2) {
e2.printStackTrace();
}
}
return result;
}

/**
* 向指定 URL 发送POST方法的请求
*
* @param url
* 发送请求的 URL
* @param param
* 请求参数,请求参数应该是 name1=value1&name2=value2 的形式。
* @return 所代表远程资源的响应结果
*/
public static String sendPost(String url, String param) {
PrintWriter out = null;
BufferedReader in = null;
String result = "";
try {
URL realUrl = new URL(url);
// 打开和URL之间的连接
URLConnection conn = realUrl.openConnection();
// 设置通用的请求属性
conn.setRequestProperty("accept", "*/*");
conn.setRequestProperty("connection", "Keep-Alive");
conn.setRequestProperty("user-agent",
"Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.1;SV1)");
// 发送POST请求必须设置如下两行
conn.setDoOutput(true);
conn.setDoInput(true);
// 获取URLConnection对象对应的输出流
out = new PrintWriter(conn.getOutputStream());
// 发送请求参数
out.print(param);
// flush输出流的缓冲
out.flush();
// 定义BufferedReader输入流来读取URL的响应
in = new BufferedReader(
new InputStreamReader(conn.getInputStream()));
String line;
while ((line = in.readLine()) != null) {
result += line;
}
} catch (Exception e) {
System.out.println("发送 POST 请求出现异常!"+e);
e.printStackTrace();
}
//使用finally块来关闭输出流、输入流
finally{
try{
if(out!=null){
out.close();
}
if(in!=null){
in.close();
}
}
catch(IOException ex){
ex.printStackTrace();
}
}
return result;
}
}

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
~/Sites/languageDiff/io » java Main
java time: 1416ms
-------------------------------------------------------
~/Sites/languageDiff/io » java Main
java time: 1472ms
-------------------------------------------------------
~/Sites/languageDiff/io » java Main
java time: 1328ms
-------------------------------------------------------
~/Sites/languageDiff/io » java Main
java time: 1348ms
-------------------------------------------------------
~/Sites/languageDiff/io » java Main
java time: 1336ms

Go

1
go version go1.10.3 darwin/amd64
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
package main

import (
"fmt"
"io/ioutil"
"net/http"
"strconv"
"sync"
"time"
)

func main() {
wg := sync.WaitGroup{}
start := time.Now()
for k := 0; k < 2; k++ {
wg.Add(1)
go func(k int) {
for i := 0; i < 10; i++ {
HttpGet("http://2018.ip138.com/ic.asp?count=" + strconv.Itoa(i*2+k))
}
wg.Done()
}(k)
}
wg.Wait()
fmt.Printf("cost time: %f\n", time.Now().Sub(start).Seconds())
}

func HttpGet(url string) string {
resp, err := http.Get(url)
if err != nil {
return err.Error()
}
defer resp.Body.Close()
body, err := ioutil.ReadAll(resp.Body)
if err != nil {
return err.Error()
}
return string(body)
}

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
~/Workspaces/go » go run main.go
cost time: 0.952737
-------------------------------------------------------
~/Workspaces/go » go run main.go
cost time: 0.983901
-------------------------------------------------------
~/Workspaces/go » go run main.go
cost time: 0.967799
-------------------------------------------------------
~/Workspaces/go » go run main.go
cost time: 0.972302
-------------------------------------------------------
~/Workspaces/go » go run main.go
cost time: 0.980509

JavaScript(NodeJS)

1
2
~/Sites » node -v
v9.11.1
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
var t1 = (new Date()).getTime();  
var job = 0;
for(var i=0; i<20; i++){
get(i);
}

var t2 = (new Date()).getTime();

console.log("nodejs time:" + (t2 - t1) + "ms");


function get(i){

var http=require('http');
//get 请求外网
http.get('http://2018.ip138.com/ic.asp?count='+i,function(req,res){
var html='';
req.on('data',function(data){
html+=data;
});
req.on('end',function(){
job++
// console.info(html);
if(job == 20){
var t2 = (new Date()).getTime();
console.log("finished time:" + (t2 - t1) + "ms");
}
});
});
}

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
~/Sites/languageDiff/io » node main.js
nodejs time:25ms
finished time:236ms
-------------------------------------------------------
~/Sites/languageDiff/io » node main.js
nodejs time:21ms
finished time:220ms
-------------------------------------------------------
~/Sites/languageDiff/io » node main.js
nodejs time:22ms
finished time:230ms
-------------------------------------------------------
~/Sites/languageDiff/io » node main.js
nodejs time:21ms
finished time:227ms
-------------------------------------------------------
~/Sites/languageDiff/io » node main.js
nodejs time:20ms
finished time:221ms

Python

1
2
~/Sites » python -V
Python 2.7.10
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
import time,urllib2

def get(url):
req = urllib2.Request(url)

res_data = urllib2.urlopen(req)
res = res_data.read()
return res


t = time.time()

for i in xrange(0, 20):
# print "Get("+str(i)+"):"
data = get("http://2018.ip138.com/ic.asp?count="+str(i))
# print data

print 'Python time: %.02fs' % (time.time() - t)

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
~/Sites/languageDiff/io » python main.py
Python time: 1.98s
-------------------------------------------------------
~/Sites/languageDiff/io » python main.py
Python time: 1.98s
-------------------------------------------------------
~/Sites/languageDiff/io » python main.py
Python time: 2.01s
-------------------------------------------------------
~/Sites/languageDiff/io » python main.py
Python time: 2.07s
-------------------------------------------------------
~/Sites/languageDiff/io » python main.py
Python time: 2.20s
-------------------------------------------------------
~/Sites/languageDiff/io » python main.py
Python time: 2.08s

目前这几种编程语言看来,排序如下:

  1. NodeJs 平均 0.23s
  2. Go 平均 0.97s
  3. Java 平均 1.38s
  4. PHP 平均 2.03s
  5. Python 平均 2.05s

Ps: 如果你希望看到自己喜欢的语言也排进来,欢迎提供代码!

阅读剩下更多

不同语言对网络IO的效率对比
编程语言

不同语言的基本性能测试

计算时间对比图
测试机器配置:

  • MacBook Air (13-inch, Early 2014)
  • 处理器:1.4 GHz Intel Core i5
  • 内存:4 GB 1600 MHz DDR3

PHP

1
2
3
PHP 7.1.16 (cli) (built: Mar 31 2018 02:59:59) ( NTS )
Copyright (c) 1997-2018 The PHP Group
Zend Engine v3.1.0, Copyright (c) 1998-2018 Zend Technologies
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
<?php
$t1 = microtime(true);

for($i=0; $i<10000000; $i++){
aaa($i);
}

$t2 = microtime(true);

echo 'php time:' . ($t2 - $t1)*1000 . "ms\n";

function aaa($i){
$a = $i + 1;
$b = 2.3;
$s = "abcdefkkbghisdfdfdsfds";

if($a > $b){
++$a;
}else{
$b = $b + 1;
}

if($a == $b){
$b = $b + 1;
}

$c = $a * $b + $a / $b - pow($a, 2);
$d = substr($s, 0, strpos($s, 'kkb')) . strval($c);
}
?>

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
~/Sites » php tes.php
php time:8196.1958408356ms
-------------------------------------------------------
~/Sites » php tes.php
php time:7649.4419574738ms
-------------------------------------------------------
~/Sites » php tes.php
php time:7908.7510108948ms
-------------------------------------------------------
~/Sites » php tes.php
php time:7708.6410522461ms
-------------------------------------------------------
~/Sites » php tes.php
php time:7515.1500701904ms
-------------------------------------------------------
~/Sites » php tes.php
php time:7468.3780670166ms

Java

1
2
3
java version "10.0.1" 2018-04-17
Java(TM) SE Runtime Environment 18.3 (build 10.0.1+10)
Java HotSpot(TM) 64-Bit Server VM 18.3 (build 10.0.1+10, mixed mode)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
public class Main {

public static void main(String[] args) {
long t1 = System.currentTimeMillis();

for(int i=0; i<10000000; i++){
aaa((float)i);
}

long t2 = System.currentTimeMillis();

System.out.println("java time: " + String.valueOf(t2 - t1) + "ms");
}

static void aaa(float i) {
float a = i + 1;
float b = 2.3f;
String s = "abcdefkkbghisdfdfdsfds";

if(a > b){
++a;
}else{
b = b + 1;
}

if(a == b){
b = b + 1;
}

float c = (float)(a * b + a / b - Math.pow(a, 2));
String d = s.substring(0, s.indexOf("kkb")) + String.valueOf(c);
}
}

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
~/Sites » java Main
java time: 1537ms
-------------------------------------------------------
~/Sites » java Main
java time: 1497ms
-------------------------------------------------------
~/Sites » java Main
java time: 1466ms
-------------------------------------------------------
~/Sites » java Main
java time: 1610ms
-------------------------------------------------------
~/Sites » java Main
java time: 1488ms
-------------------------------------------------------
~/Sites » java Main
java time: 1503ms
-------------------------------------------------------
~/Sites » java Main
java time: 1475ms

Go

1
go version go1.10.3 darwin/amd64
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
package main

import (
"fmt"
"math"
"strconv"
"strings"
"time"
)

func main() {
t1 := time.Now()
for i := 0; i < 10000000; i++ {
Aaa(float64(i))
}
t2 := time.Now()
fmt.Printf("Go time: %f s\n", t2.Sub(t1).Seconds())
}

func Aaa(i float64) {
var a float64 = i + 1
var b float64 = 2.3
s := "abcdefkkbghisdfdfdsfds"

if a > b {
a++
} else {
b = b + 1
}

if a == b {
b = b + 1
}

c := a*b + a/b - math.Pow(a, 2)
d := s[0:strings.Index(s, "kkb")] + strconv.FormatFloat(c, 'E', -1, 64)
_ = d
}

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
~/Workspaces/GoLand/src/Aaa » go build main.go
-------------------------------------------------------
~/Workspaces/GoLand/src/Aaa » ./main
Go time: 4.083166 s
-------------------------------------------------------
~/Workspaces/GoLand/src/Aaa » ./main
Go time: 4.095651 s
-------------------------------------------------------
~/Workspaces/GoLand/src/Aaa » ./main
Go time: 4.154200 s
-------------------------------------------------------
~/Workspaces/GoLand/src/Aaa » ./main
Go time: 4.175203 s
-------------------------------------------------------
~/Workspaces/GoLand/src/Aaa » ./main
Go time: 4.111375 s

Go并发版本

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
package main

import (
"fmt"
"math"
"strconv"
"strings"
"sync"
"time"
)

func main() {
wg := sync.WaitGroup{}
t1 := time.Now()
for k := 0; k < 2; k++ {
wg.Add(1)
go func() {
for i := 0; i < 5000000; i++ {
Aaa(float64(i))
}
wg.Done()
}()
}
wg.Wait()
t2 := time.Now()
fmt.Printf("Go time: %f s\n", t2.Sub(t1).Seconds())
}

func Aaa(i float64) {
var a float64 = i + 1
var b float64 = 2.3
s := "abcdefkkbghisdfdfdsfds"

if a > b {
a++
} else {
b = b + 1
}

if a == b {
b = b + 1
}

c := a*b + a/b - math.Pow(a, 2)
_ = s[0:strings.Index(s, "kkb")] + strconv.FormatFloat(c, 'E', -1, 64)
}

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
~/Workspaces/GoLand/src/Aaa » go build main.go
-------------------------------------------------------
~/Workspaces/GoLand/src/Aaa » ./main
Go time: 2.326077 s
-------------------------------------------------------
~/Workspaces/GoLand/src/Aaa » ./main
Go time: 2.270769 s
-------------------------------------------------------
~/Workspaces/GoLand/src/Aaa » ./main
Go time: 2.277345 s
-------------------------------------------------------
~/Workspaces/GoLand/src/Aaa » ./main
Go time: 2.252540 s
-------------------------------------------------------
~/Workspaces/GoLand/src/Aaa » ./main
Go time: 2.255374 s

JavaScript(NodeJS)

1
2
~/Sites » node -v
v9.11.1
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
var t1 = (new Date()).getTime();  

for(var i=0; i<10000000; i++){
aaa(i);
}

var t2 = (new Date()).getTime();

console.log("nodejs time:" + (t2 - t1) + "ms");


function aaa(i){
var a = i + 1;
var b = 2.3;
var s = "abcdefkkbghisdfdfdsfds";

if(a > b){
++a;
}else{
b = b + 1;
}

if(a == b){
b = b + 1;
}

var c = a * b + a / b - Math.pow(a, 2);

var d = s.substring(0, s.indexOf("kkb")) + c.toString();
}

测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
~/Sites » node main.js
nodejs time:4898ms
-------------------------------------------------------
~/Sites » node main.js
nodejs time:5567ms
-------------------------------------------------------
~/Sites » node main.js
nodejs time:4846ms
-------------------------------------------------------
~/Sites » node main.js
nodejs time:4853ms
-------------------------------------------------------
~/Sites » node main.js
nodejs time:4955ms
-------------------------------------------------------
~/Sites » node main.js
nodejs time:5113ms

Python

1
2
~/Sites » python -V
Python 2.7.10
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import sys, time, math

def aaa(i):
a = i + 1
b = 2.3
s = "abcdefkkbghisdfdfdsfds"

if a > b:
a = a + 1
else:
b = b + 1

if a == b:
b = b + 1

c = a * b +a / b - math.pow(a, 2)

d = s[0: s.find("kkb")] + str(c)


t = time.time()

for i in xrange(0, 10000000):
aaa(i)

print 'Python time: %.02f s' % (time.time() - t)
测试结果:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
~/Sites » python main.py
Python time: 20.34
-------------------------------------------------------
~/Sites » python main.py
Python time: 19.90
-------------------------------------------------------
~/Sites » python main.py
Python time: 20.07
-------------------------------------------------------
~/Sites » python main.py
Python time: 19.88
-------------------------------------------------------
~/Sites » python main.py
Python time: 22.89

目前这几种编程语言看来,排序如下:

  1. Java 平均 1.51s (稳居第一)
  2. Go 平均 3.94s (并发2.28s)
  3. NodeJs 平均 5.03s
  4. PHP 平均 7.65s
  5. Python 平均 20.62s (差距大应该是我对这语言不熟,密集运算应该有优化方案)

Ps: 如果你希望看到自己喜欢的语言也排进来,欢迎提供代码!

阅读剩下更多

不同语言的基本性能测试
编程语言

Go语言中的切片(Slice)是引用类型还是值类型?

在最近的学习和实践中,照着别人的代码敲,仅仅只是把别人写在方法内的片段直接拿出来用,结果却出人意料,所以很纳闷!

示例代码:

1
2
3
4
5
6
7
8
func CryptBlocks(dst, src []byte) {
// ...省略内容
for len(src) > 0 {
encrypt(dst, src[:16]) //类似copy
dst = dst[16:]
src = src[16:]
}
}

这个分块处理切片数据的方法很巧妙,我第一次看见的时候(认定切片是传引用),认为这个方法错了,最终dst变成了空切片。

先看一个Slice的例子:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
package main

import(
"fmt"
)

func main () {
var slice []int
slice = make([]int, 6)
slice = []int{0,1,2,3,4,5}
fmt.Println("Slice: ",slice)
changeSlice(slice)
fmt.Println("Changed Slice: ", slice)

}

func changeSlice(s []int) {
s[2] = 100
}

输出:

1
2
Slice:  [0 1 2 3 4 5]
Changed Slice: [0 1 100 3 4 5]

我们会发现,在方法changeSlice中对形参的修改即真实修改。如果这时我们将其定性为引用传值,为之过早!

我们将代码稍微修改一下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
package main

import(
"fmt"
)

func main () {
var slice []int
slice = make([]int, 6)
slice = []int{0,1,2,3,4,5}
fmt.Printf("SliceAddr: %p , Slice: %v\r\n",&slice, slice)
changeSlice(slice)
fmt.Printf("Changed SliceAddr: %p , Changed Slice: %v\r\n", &slice, slice)

}

func changeSlice(s []int) {
fmt.Printf("In func's sliceAddr: %p\r\n", s)
s[2] = 100
}

输出:

1
2
3
SliceAddr: 0xc82000e0a0 , Slice: [0 1 2 3 4 5]
In func's sliceAddr: 0xc8200460c0
Changed SliceAddr: 0xc82000e0a0 , Changed Slice: [0 1 100 3 4 5]

由此可见,在方法内的那个s(地址:0xc8200460c0)并非传入的那个slice(地址:0xc82000e0a0),但是为什么它的修改能影响到原来的数据呢?

阅读剩下更多

默认配图
学习笔记

mysql中几种Log和打开方法

Mysql中常见的log有:错误日志log_error慢查询日志slow_query_log二进制日志bin_log通用查询日志general_log

错误日志(error_log)

这个日志记载mysql服务器的启动和关闭以及运行过程中发生的故障或异常情况,如果你发现mysql无法正常启动,那么你首先应该查看这个日志。

配置:

1
log_error = error.log

服务器上查询log位置:show variables like 'log_error'

慢查询日志(slow_query_log)

为了改善数据库性能,需要减少慢查询SQL的使用次数,那么哪些SQL需要改善呢?通过这个日志可以更清楚如何去改善。

配置:

1
2
3
slow_query_log = 1
lone_query_time = 10
slow_query_log_file = slow_query.log

二进制查询日志(bin_log)

Mysql的binlog日志作用是用来记录mysql内部增删改查等对mysql数据库有更新的内容的记录(对数据库的改动),对数据库的查询select或show等不会被binlog日志记录;主要用于数据库的主从复制以及增量恢复。

配置:

1
log_bin = mysql_bin.log

通用查询日志(general_log)

会记录mysql运行期间的所有sql语句

配置:

1
2
3
log_output=[none|file|table|file,table]  #通用查询日志输出格式
general_log=[on|off] #是否启用通用查询日志
general_log_file[=filename] #通用查询日志位置及名字

阅读剩下更多

默认配图
学习笔记

skip-name-resolve可以解决远程连接mysql数据库时候的缓慢或超时

  咳咳,迁了新的机器,全新的机器但是环境还是跟以前一样,基本没变过什么配置。但是远程连接mysql却很慢,甚至10s超时都还没连上!!! 当然,仅仅只是建立连接的时候,连接成功后一切操作都行如流水。

  所以最快最简单的方法就是直接在数据库的配置文件my.cnf|my.ini中添加一行skip-name-resolve来解决。

  其实mysql在用户登录建立连接的时候,会对客户端进行DNS反查,如果遇到服务器的DNS解析出现问题,那么就可能导致客户端迟迟连接不上。此方法可禁止mysql进行DNS反查从而解决了这个问题。

阅读剩下更多

默认配图
学习笔记

Laravel5.5 发送邮件遇到Connection could not be established with host xxxxx

Laravel输出的错误页面如下图:
Laravel异常捕获-mail

服务器:阿里云香港节点(B区) CentOS6.8 64bit

lamp环境:PHP7.2.1

Laravel .env mail部分:

1
2
3
4
5
6
7
8
MAIL_DRIVER=smtp
MAIL_HOST=hwsmtp.exmail.qq.com
MAIL_PORT=465
[email protected]
MAIL_PASSWORD=XXXXXXXX
[email protected]
MAIL_FROM_NAME=noreply
MAIL_ENCRYPTION=ssl

问题发生前景:本地测试完全正常,相同配置在服务器上就被抛出异常。

因为之前遇到过由于端口没有放行而造成无法建立连接的问题,在此问题上我也做了一样的尝试,在安全组配置里面对465端口进行放行(无论是出口还是入口)。但是结果表示并不是这个问题,而我在没有配置放行的情况下,telnet host:port 是通的。

经过大约两天的间接性排查和尝试,最终提交工单咨询阿里,他们给了我处理意见:尝试他们的Demo!

尝试阿里云提供的Demo测试发件是没有问题的,这就令我很纳闷的,于是我去看该Demo是如何建立连接的。

通过一步一步的探索,发现该Demo也是同样使用了stream_socket_client方法来建立连接,那为什么它可以,Laravel内的却不行?说明不是该环境的问题!

问题逐渐定位到了stream_socket_client这个方法上,查询PHP.NET来认识一下它。

1
resource stream_socket_client ( string $remote_socket [, int &$errno [, string &$errstr [, float $timeout = ini_get("default_socket_timeout") [, int $flags = STREAM_CLIENT_CONNECT [, resource $context ]]]]] )

方法描述上,只有一个参数可能会不一样,就是最后那个$context,它是一个Resource,由stream_conntext_create方法创建并返回。

我注意到Laravel中使用的Swift_Mailer所引用的StreamBuffer类中,在stream_socket_client方法前面加上了@符号来屏蔽error,而在下面自己判断来抛出异常。

那么我果断将@符号去掉! 真正的错误爆出来了!!!!

1
2
stream_socket_enable_crypto(): SSL operation failed with code 1. OpenSSL Error messages:
error:14090086:SSL routines:ssl3_get_server_certificate:certificate verify failed

乍眼一看,证书校验失败????

上面的废话只是简单描述我遇到这个问题是如何应对的

解决方案来了! 既然是走SSL协议(465端口),且程序抛出错误为证书校验失败,那么就去直接搜索有关Laravel/SwitEmailer的证书校验问题。

在stackOverflow上找到两个相关的问题:

  1. localhost and “stream_socket_enable_crypto(): SSL operation failed with code 1”
  2. how to fix stream_socket_enable_crypto(): SSL operation failed with code 1

他们都提出了一个配置:

1
2
3
4
5
6
7
8
9
//	在/config/mail.php中增加

'stream' => [
'ssl' => [
'allow_self_signed' => true,
'verify_peer' => false,
'verify_peer_name' => false,
],
],

然后测试,Bingo!!!

当然,既然是SSL必然使用校验才是最安全的,但是我这里仅满足能够发件即可,至于如何进行证书校验,请移步:使用PHPMailer 中的报错解决 “Connection failed. Error #2: stream_socket_client(): SSL operation failed with code 1. OpenSSL Error messages:”

阅读剩下更多

默认配图
Linux

Apache设置目录的访问权限(用户名和密码)

  最近重新搞了个阿里云香港ECS用来科学上网,另外使用LAMP一键安装包搭环境,搭建完成后开放云盾端口即可通过IP访问到web默认页,这默认页有些实用的小工具,如:探针、MyAdmin啥的。如图:


  然后我想让这默认页只有我自己能看到,其他人最好不要看到,毕竟其他人看到也没啥用,最多给服务器施压而已,然后就想弄个如下图的效果:


  下面来讲讲如何实现此效果的步骤,假设需要设置权限的目录(DIR)为”/data/www/default”

  • 修改apache的配置文件(可以是httpd.conf,也可以是具体的vhost的单独配置文件),内容如下:
1
2
3
4
5
6
<Directory "/data/www/default">
Options Indexes
AllowOverride AuthConfig
Order allow,deny
Allow from all
</Directory>
  • 在DIR下新增.htaccess文件,内容如下
1
2
3
4
AuthName "sys"
AuthType Basic
AuthUserFile /data/www/default/.htpasswd
require user username
  • 使用Apache的htpasswd创建.htpasswd文件
1
2
/usr/local/apache/bin/htpasswd -c /data/www/default/.htpasswd username
##这里会提示你输入两次密码##

  完成上述步骤后,重启Apache即可

阅读剩下更多

默认配图
返回顶部